DPDK 模拟物理网卡实现
这篇记录一个小东西: 在 BlueField-2 (BF2) 的 Arm 上用 DPDK 写一个逐帧严格限速的整形器 dpu_shaper, 让一张 100G 的网卡老老实实地扮演一根 10G / 25G 的网线. 代码 800 来行 C, 修了四个大 bug, 背后都是同一句话: 把限速从网卡里搬出来以后, 发送方就看不见它了.
起因: VF 限速是个假的 25G
实验要模拟 “某个节点网卡变慢了” (straggler). 最省事的做法是给它的 VF 设 max_tx_rate, 长期平均看确实是 25G. 问题在短时间尺度: VF 限速器是一个 token bucket, 额度按 cap 补充没毛病, 离谱的是桶很深 (BF2 上空闲超过约 45 ms, 一次能放出 35-100 MB), 而且有额度时 VF 以网卡内部速度 (约 98G) 整块冲出去.
NCCL 每一步之间恰好有几百微秒的空档, 25G 下空 356 µs 就攒出约 1 MB, 正好够下一个 1 MiB 的 step 整块冲出去. 于是 “25G 的慢节点” 每一步都在用 98G 发, 这 straggler 比健康节点还快.
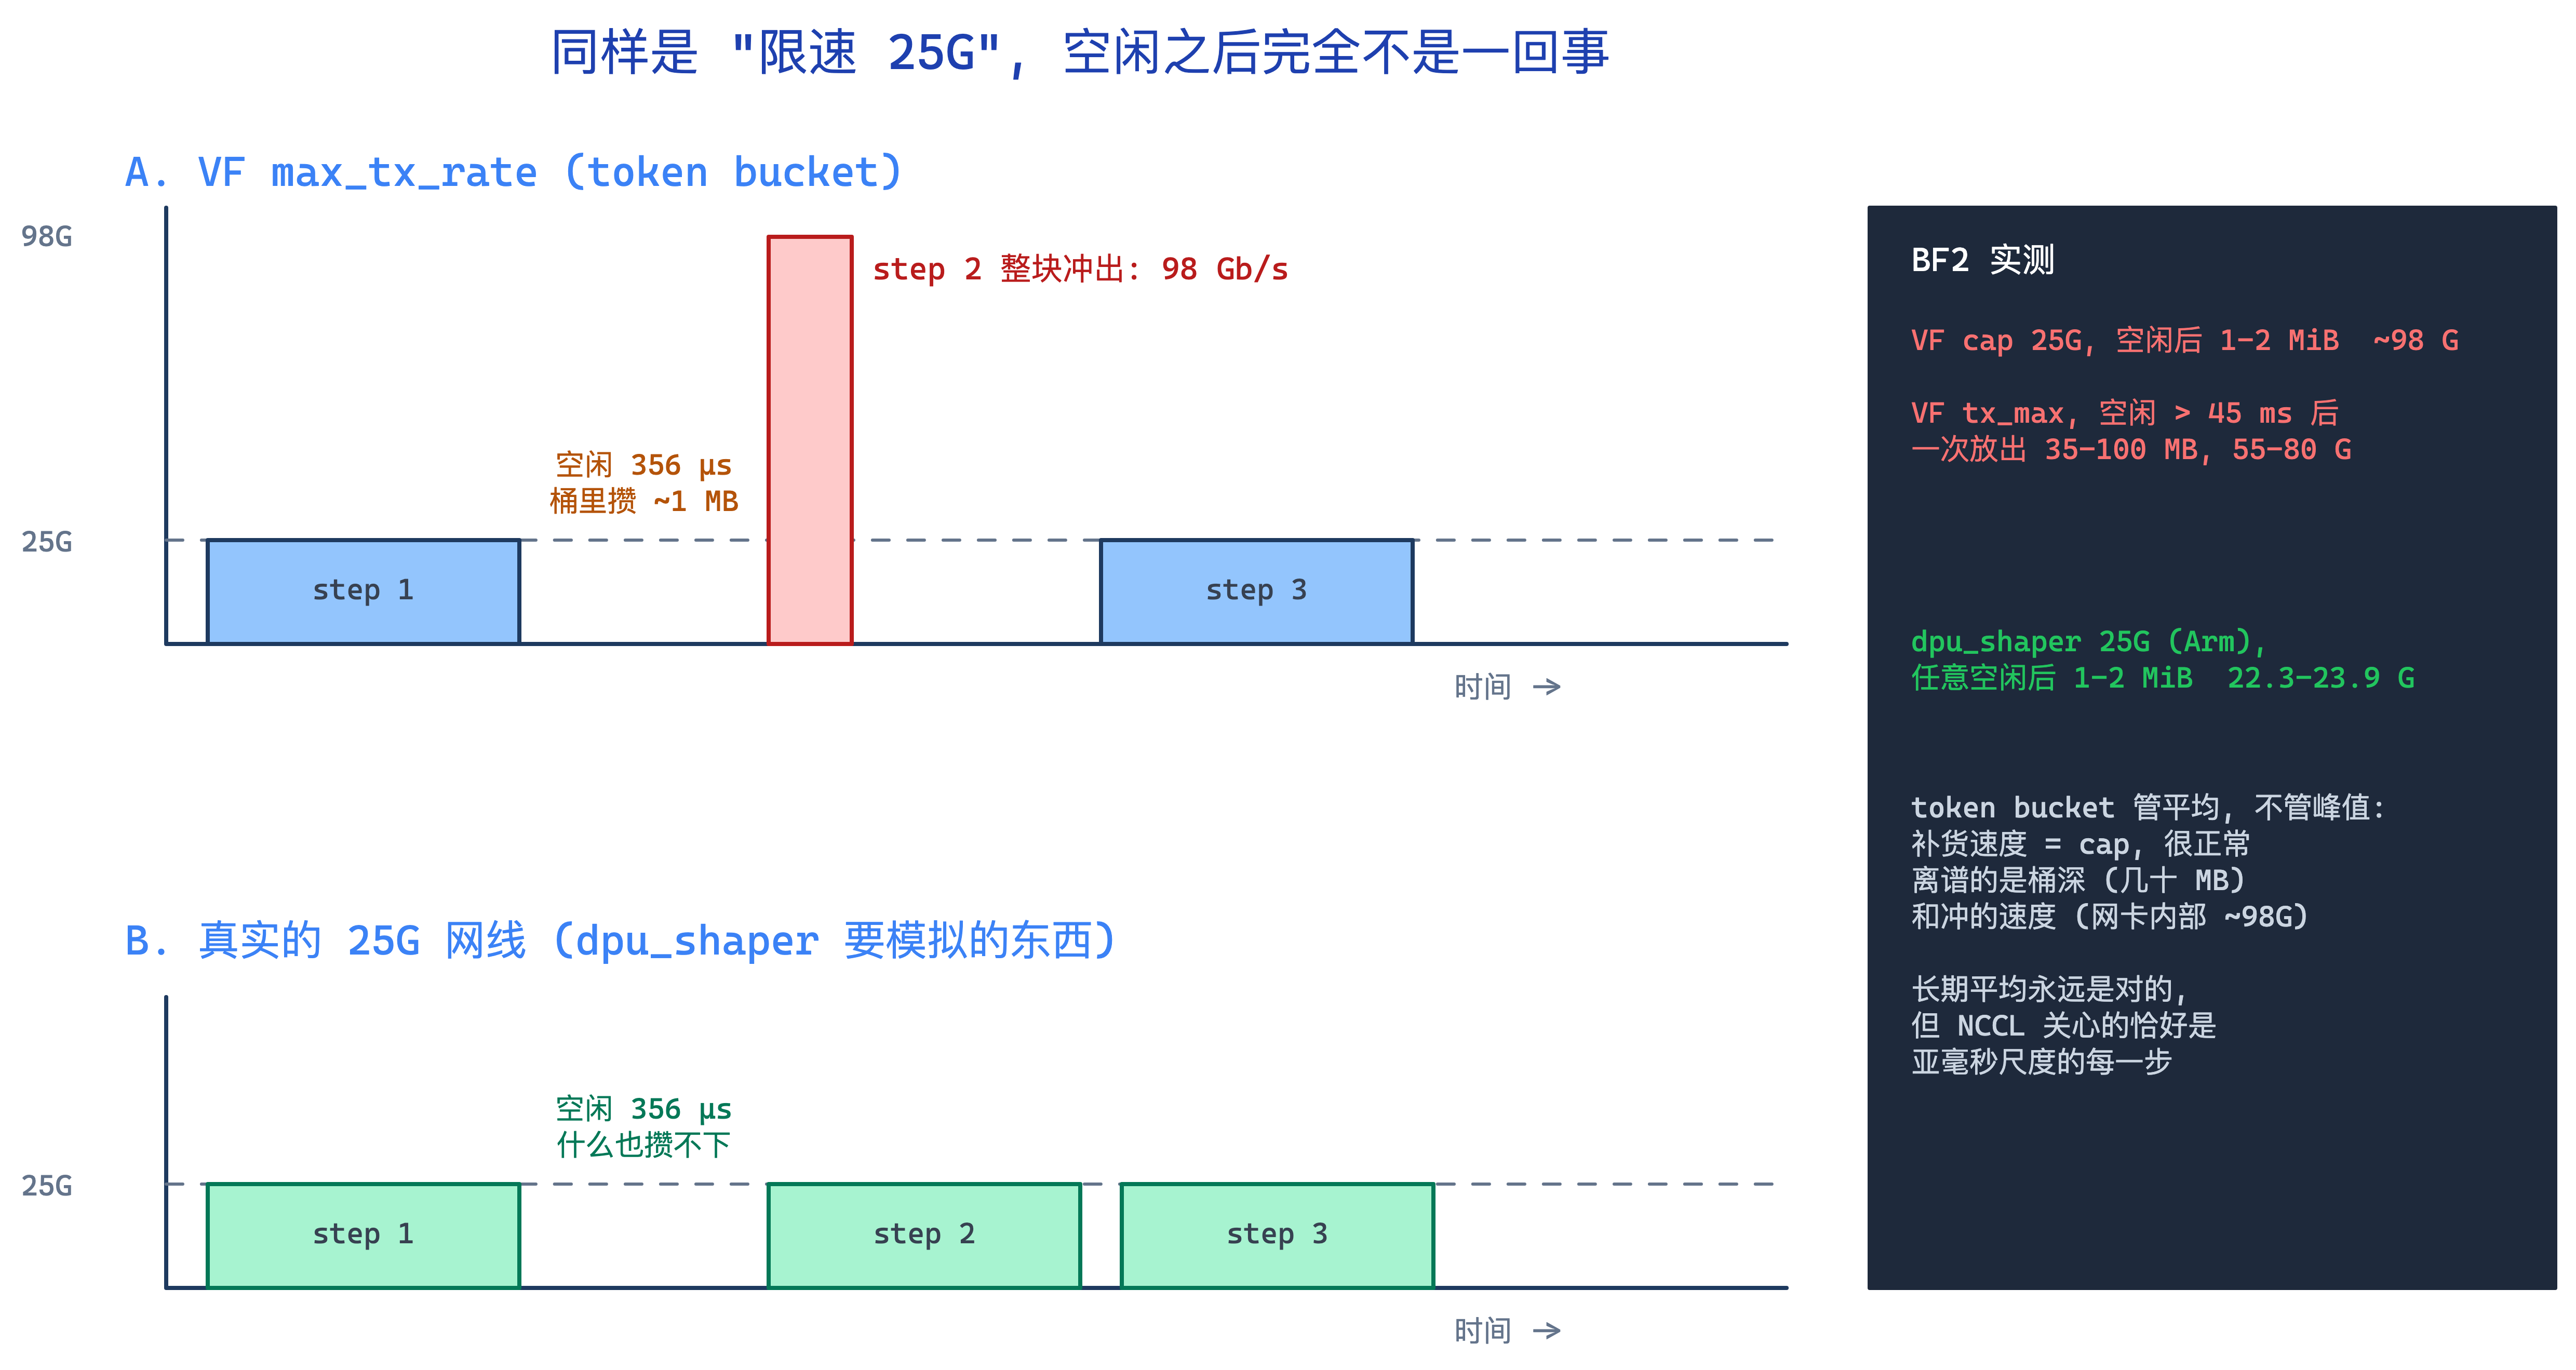
试过挂一条背景填充流去填空档, 也只能把 burst 压低, 做不到逐包严格. 真实的网线物理上就不可能超速, 要模拟它, 限速只能挪到网卡外面, 逐帧做.
DPDK 是什么
BF2 不只是网卡, 它是 DPU: 卡上自带 8 个 Cortex-A72, 跑完整的 Linux. 切到 DPU 模式后, 主机上每个 VF 在 Arm 侧都有一个代表端口 (representor), VF 发的帧可以先交给 Arm, 由 Arm 决定什么时候上线. Arm 上做转发可以用内核 tc, 但 A72 的内核转发扛不住几十 G 的 RoCE, 所以选了 DPDK.
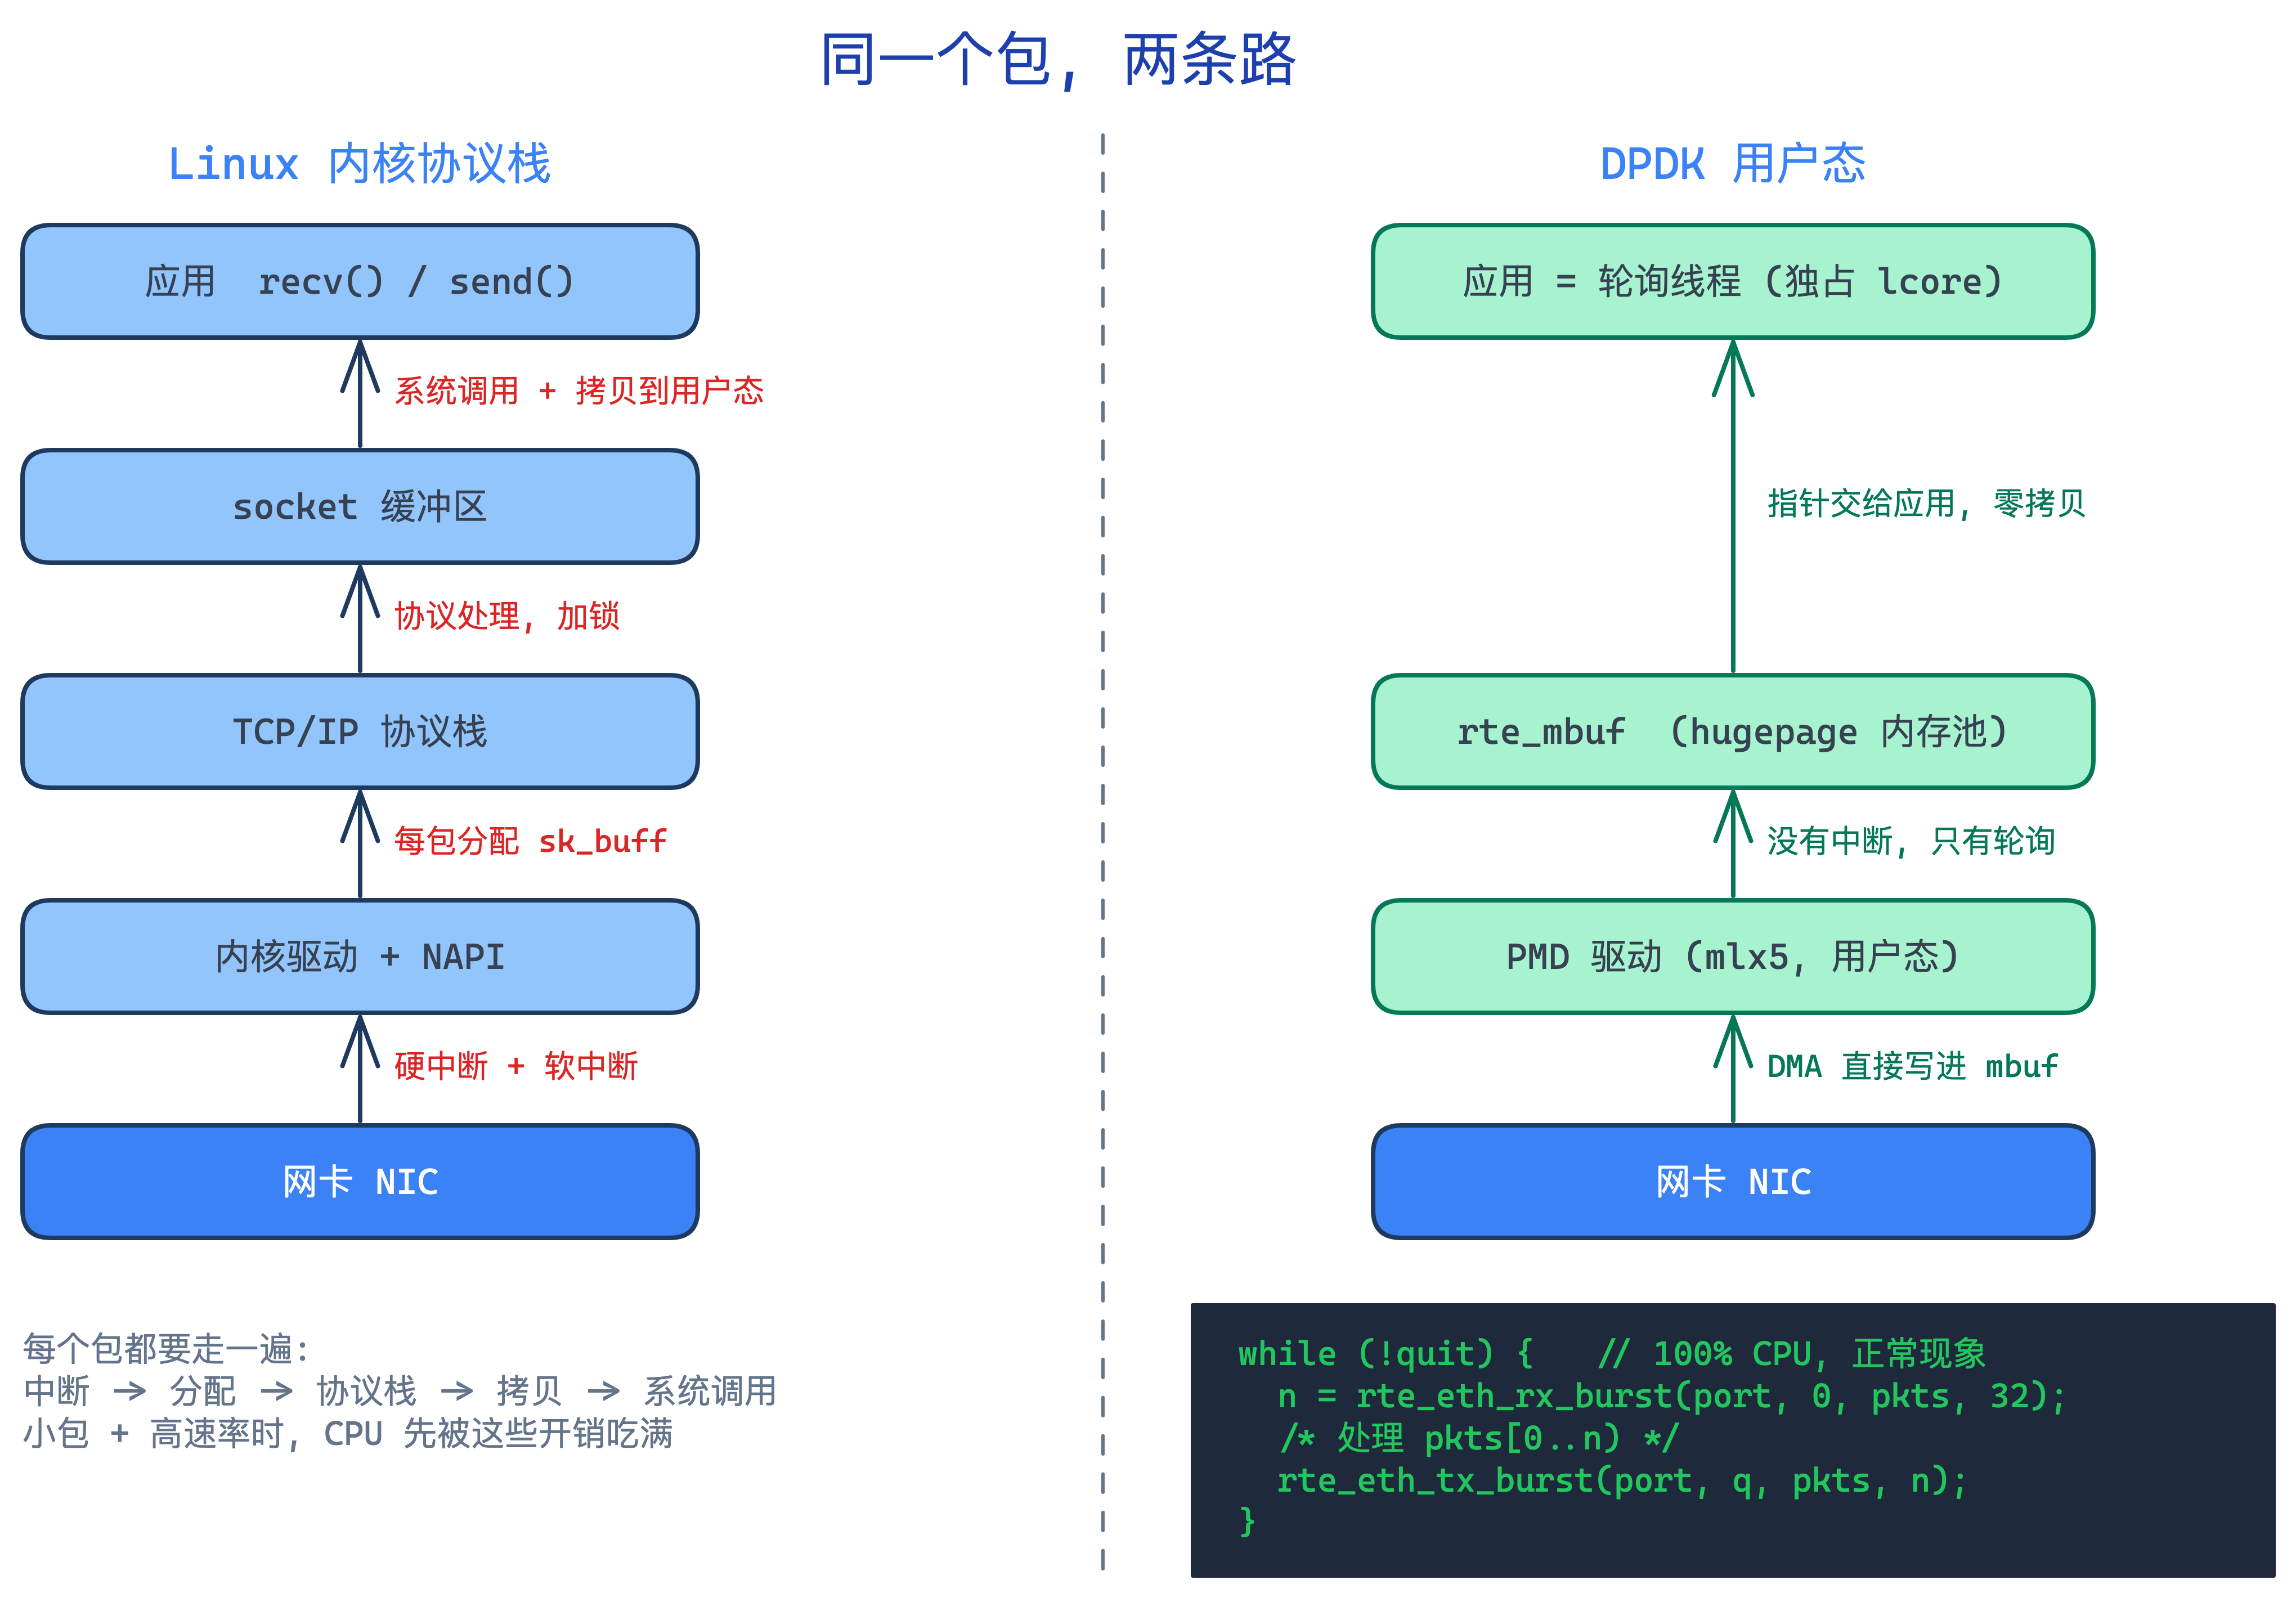
一句话: DPDK 把网卡驱动搬到用户态, 用一个独占的核死循环轮询网卡, 绕开内核协议栈. 内核收一个包要过中断, 分配 sk_buff, 协议栈, 拷贝, 系统调用; DPDK 让网卡 DMA 直接把帧写进用户态内存池, 应用拿到的是指针.
| 概念 | 是什么 |
|---|---|
EAL (rte_eal_init) |
程序第一件事. 解析 -l 0-5 这类参数, 绑核, 映射大页, 探测网卡 |
| lcore | 被钉死在某个核上的线程, 约定这个核不干别的 |
| hugepage + mbuf pool | 帧放在大页上的预分配内存池里, 收发只借还, 不 malloc, 网卡直接 DMA |
| PMD (mlx5) | 用户态驱动. mlx5 和内核驱动共存 (bifurcated), 不用把网卡从内核解绑 |
rx_burst / tx_burst |
一次收发一批帧, 所有 DPDK 主循环都长这样 |
rte_flow |
往网卡硬件写匹配规则 |
| representor | DPU 模式下 Arm 侧代表主机 VF 的端口, 用 -a <PCI>,representor=vf[0-4] 打开 |
DPDK 只管把包高效地搬进搬出, 不带协议栈. 官方也没有 Rust 接口, 所以老老实实写 C.
dpu_shaper 的设计
TX 方向的每一帧先绕进 Arm 内存, 按一根虚拟网线的时钟出队再上线; RX 方向不整形, 用 eSwitch 的 transfer rule 按目的 MAC 直接送到 VF, 不碰 Arm CPU.
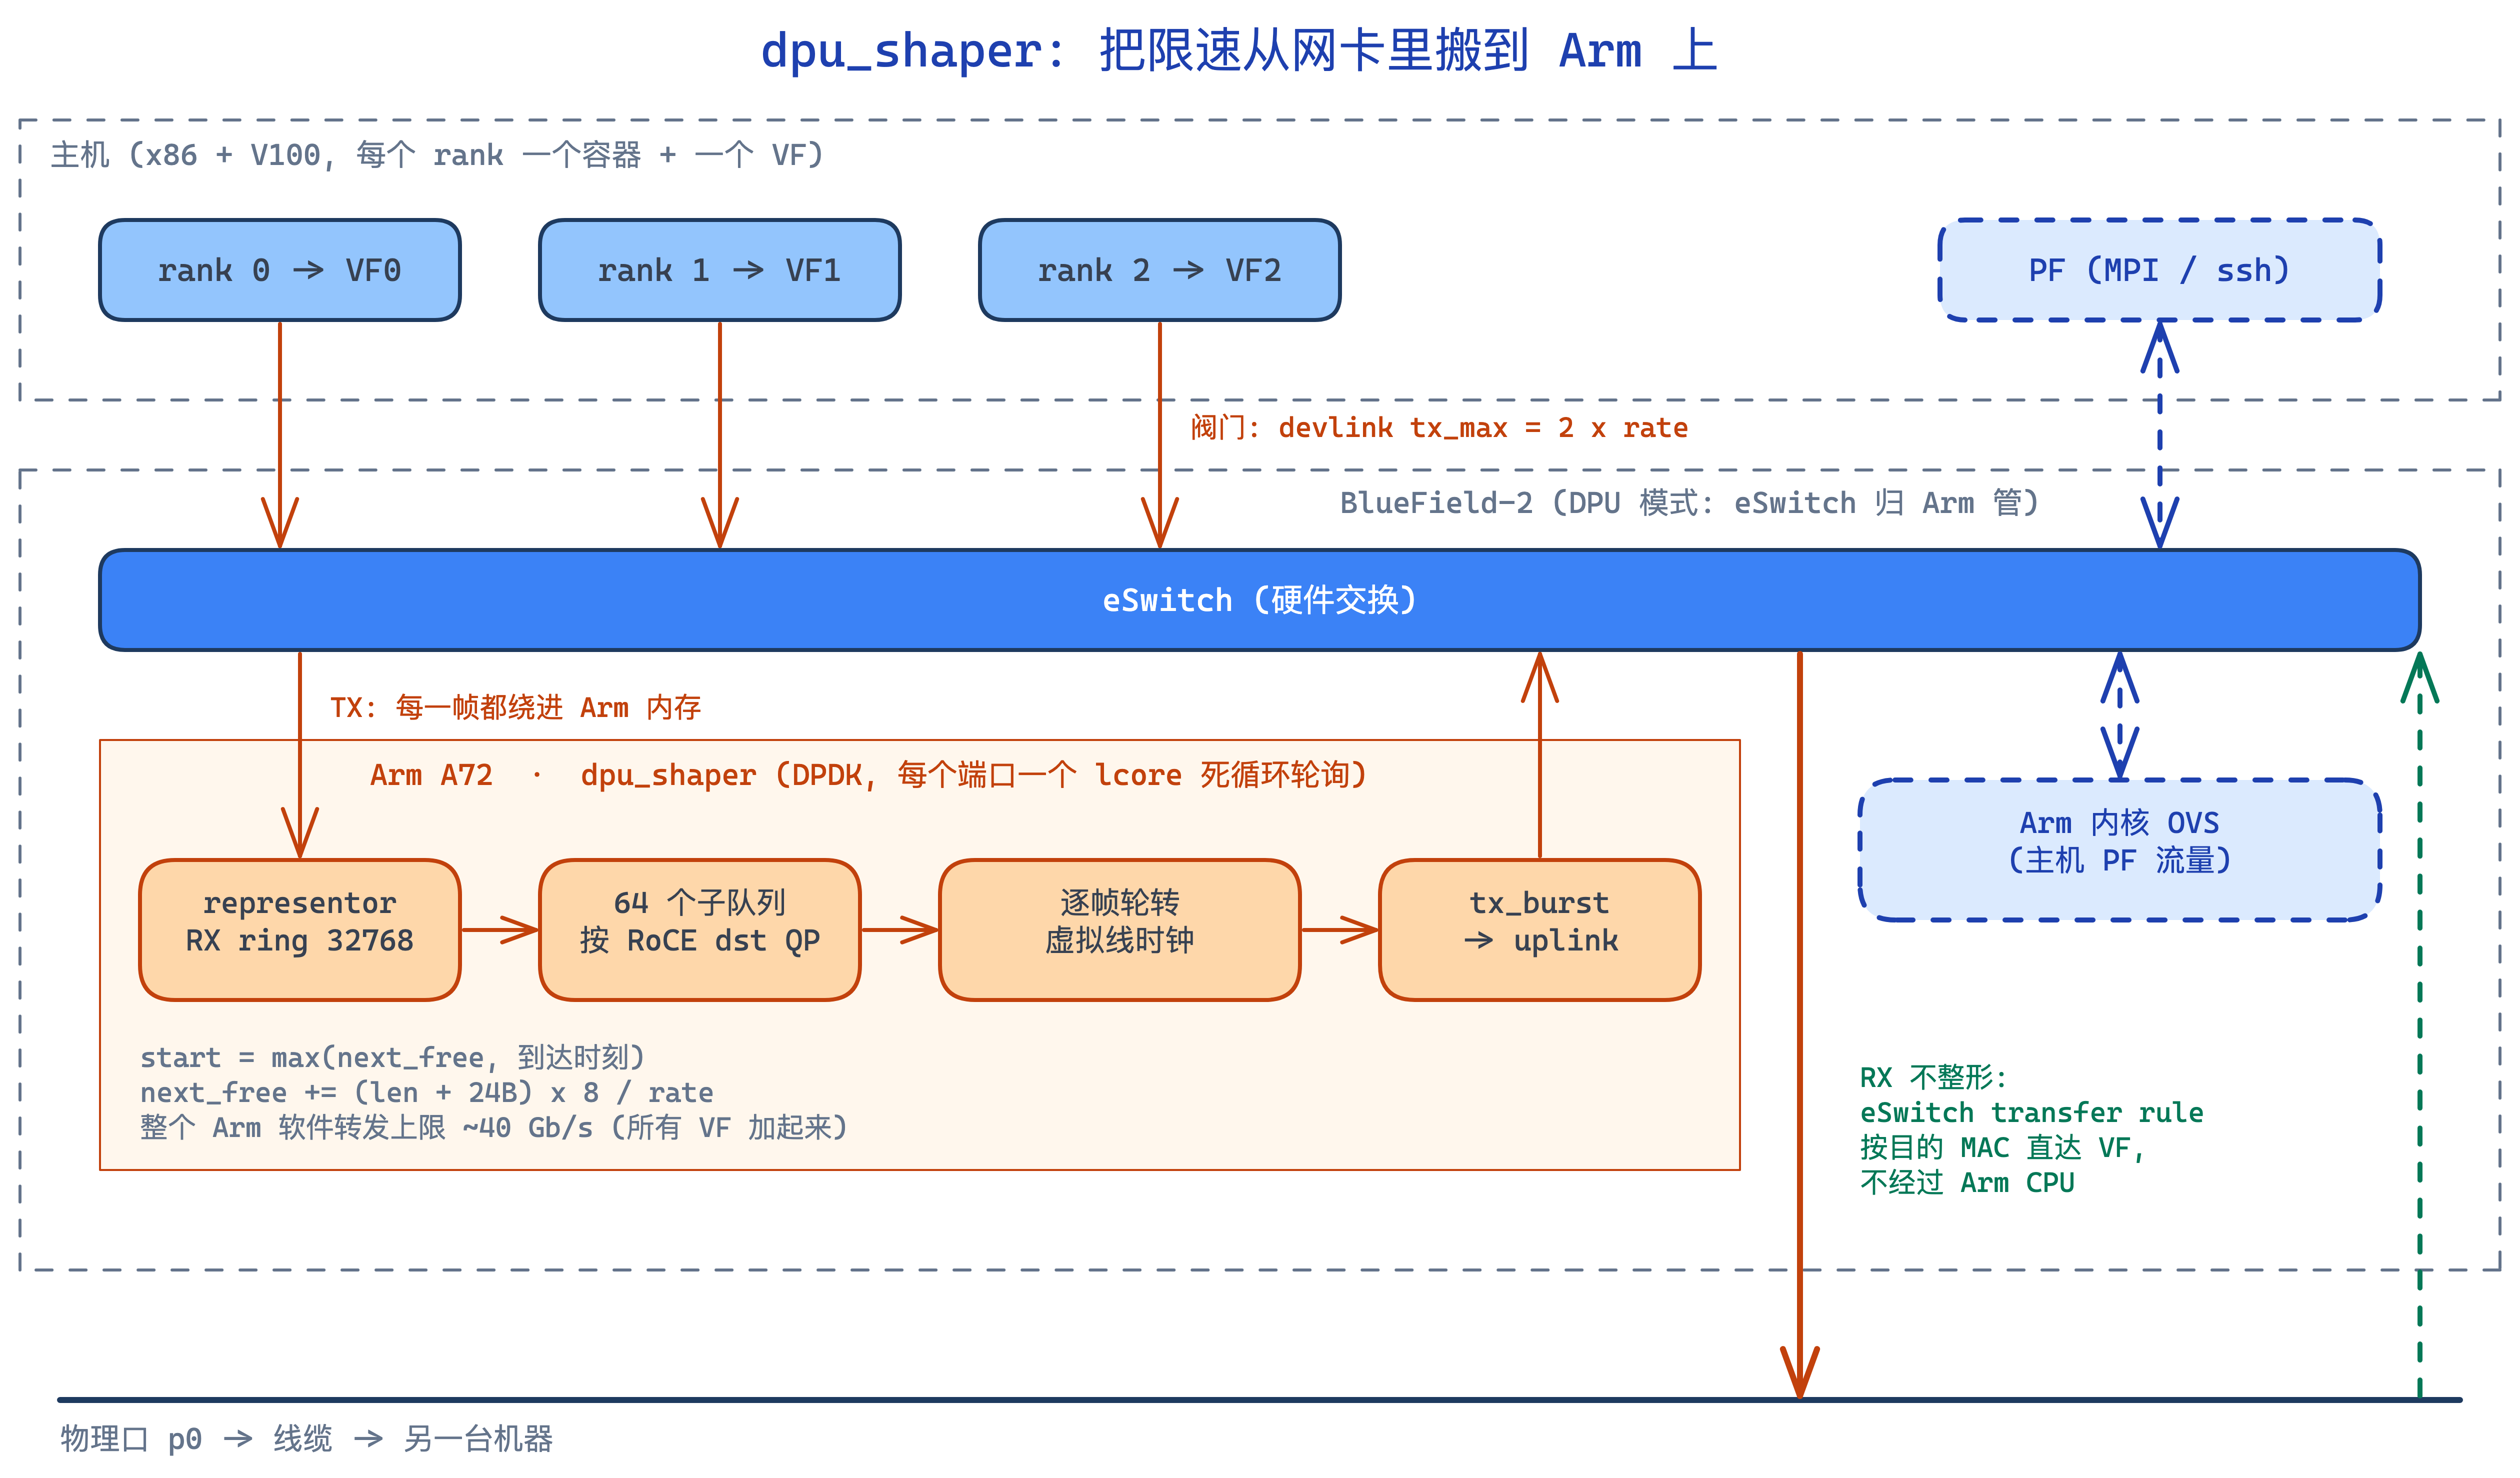
虚拟网线就是每个 VF 一个 next_free_ps (这根线下次空闲的时刻), 每帧占用 (len + 24 B) x 8 / rate 的线时间 (24 B = FCS + 前导码 + 帧间隙), 出发时刻 = max(线空闲时刻, 帧到达时刻). 和 token bucket 的本质区别: 线空着的时候什么也攒不下.
shaper.c 不依赖 DPDK, 可以单独单测. 主循环每次 poll:
1 | uint16_t n = rte_eth_rx_burst(p->cfg.port, 0, pkts, want); // want = 队列剩余空间 |
tx_burst 可能只收下一部分, 所以 peek / commit 分开: 没收的帧留在队头, 时钟只为真正发出去的帧前进. 队列满了就少收, 积压留在网卡 RX ring 里, 整形器自己不主动丢包.
Bug 1: NCCL 直接冻住
切到 DPU 模式, perftest 跑整形一切完美, 换 NCCL 以后 64 KiB 的 AllReduce 要 137.6 ms, 基本等于死了.
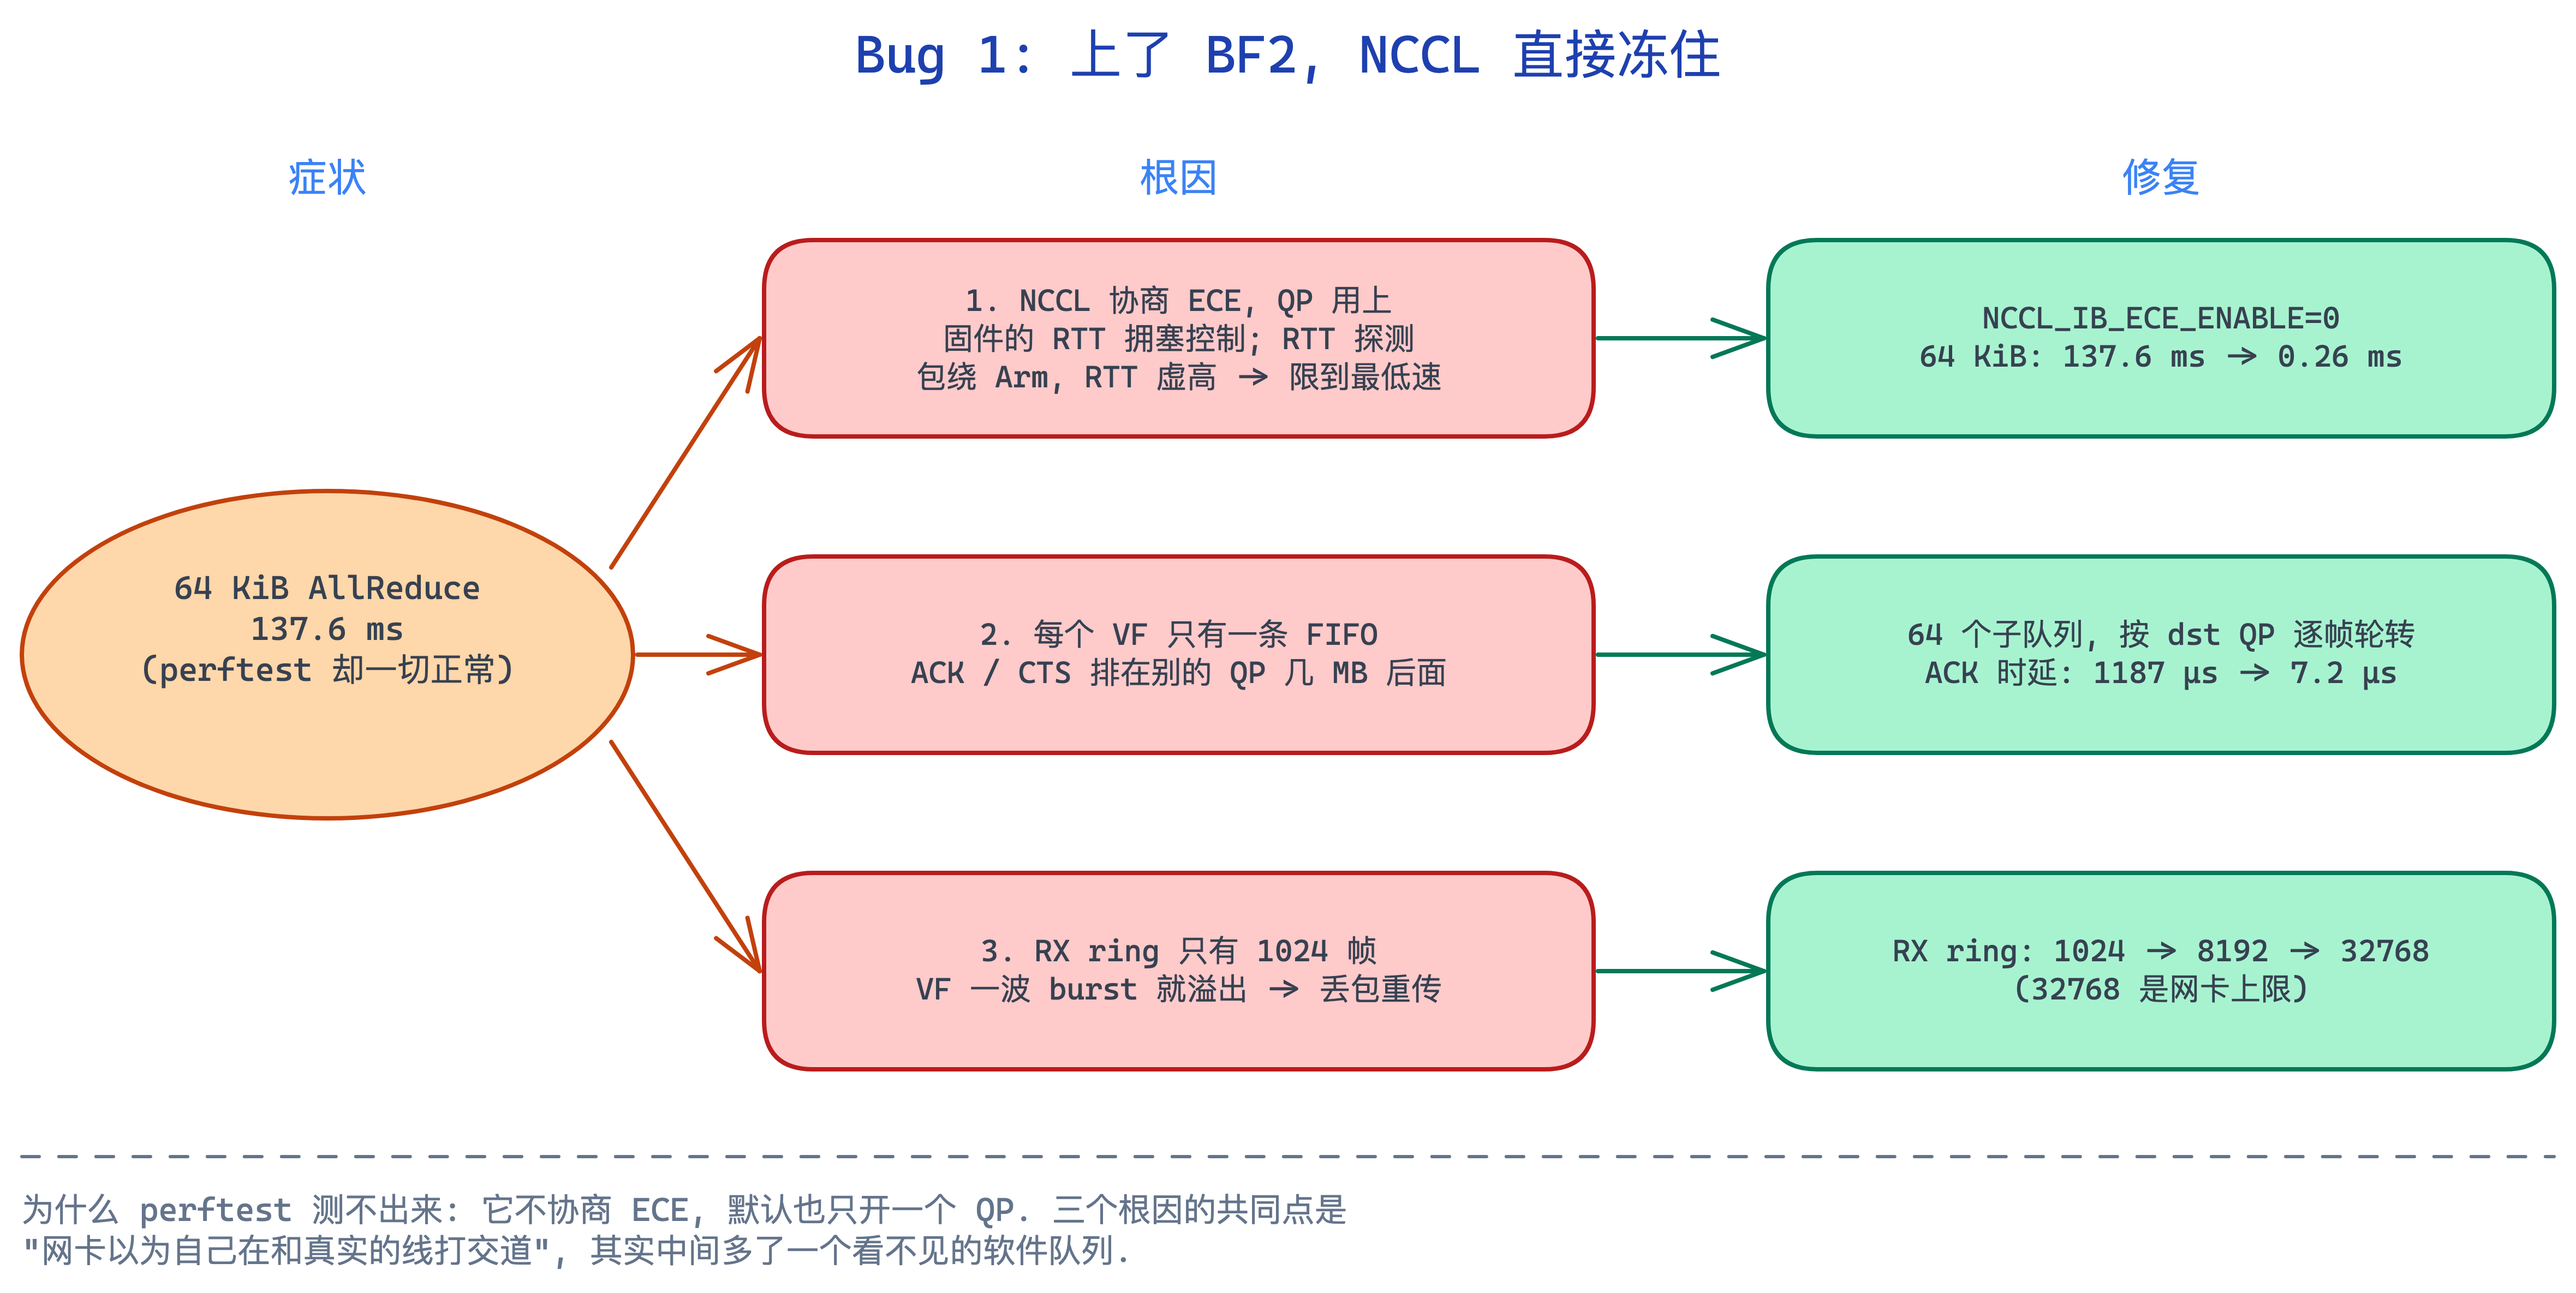
三个根因叠在一起:
- ECE. NCCL 建连接时和对端协商 ECE, QP 因此用上固件基于 RTT 的拥塞控制. RTT 探测包也绕 Arm 的软件队列, RTT 虚高, 固件以为网络堵死, 把 QP 压到最低速. perftest 不协商 ECE 所以测不出来.
NCCL_IB_ECE_ENABLE=0后 137.6 ms 变 0.26 ms. - 一个 VF 一条 FIFO. VF 把所有 QP 的数据一口气倒进 Arm, 几十字节的 ACK / CTS 排在别的 QP 几 MB 后面, 5.6 µs 变 1187 µs. 真网卡按 QP 仲裁, shaper 也照做: 64 个子队列按目的 QP 分流, 逐帧轮转, 共用一根线的时钟. ACK 回到 7.2 µs.
- RX ring 太小. 1024 帧, VF 一波 burst 就溢出, 丢包触发重传. 加到网卡上限 32768.
修完后对称 ring 抖动只有 0.2%. 但 Arm 软件转发总共只扛约 40 Gb/s, 一个节点 3 个 rank, 每个 rank 只能降到 10G.
Bug 2: 发送方看不见中间盒
真网卡的发送调度器就在 QP 旁边, 现在它变成了 QP 看不见的软件盒子, 带来两个问题.
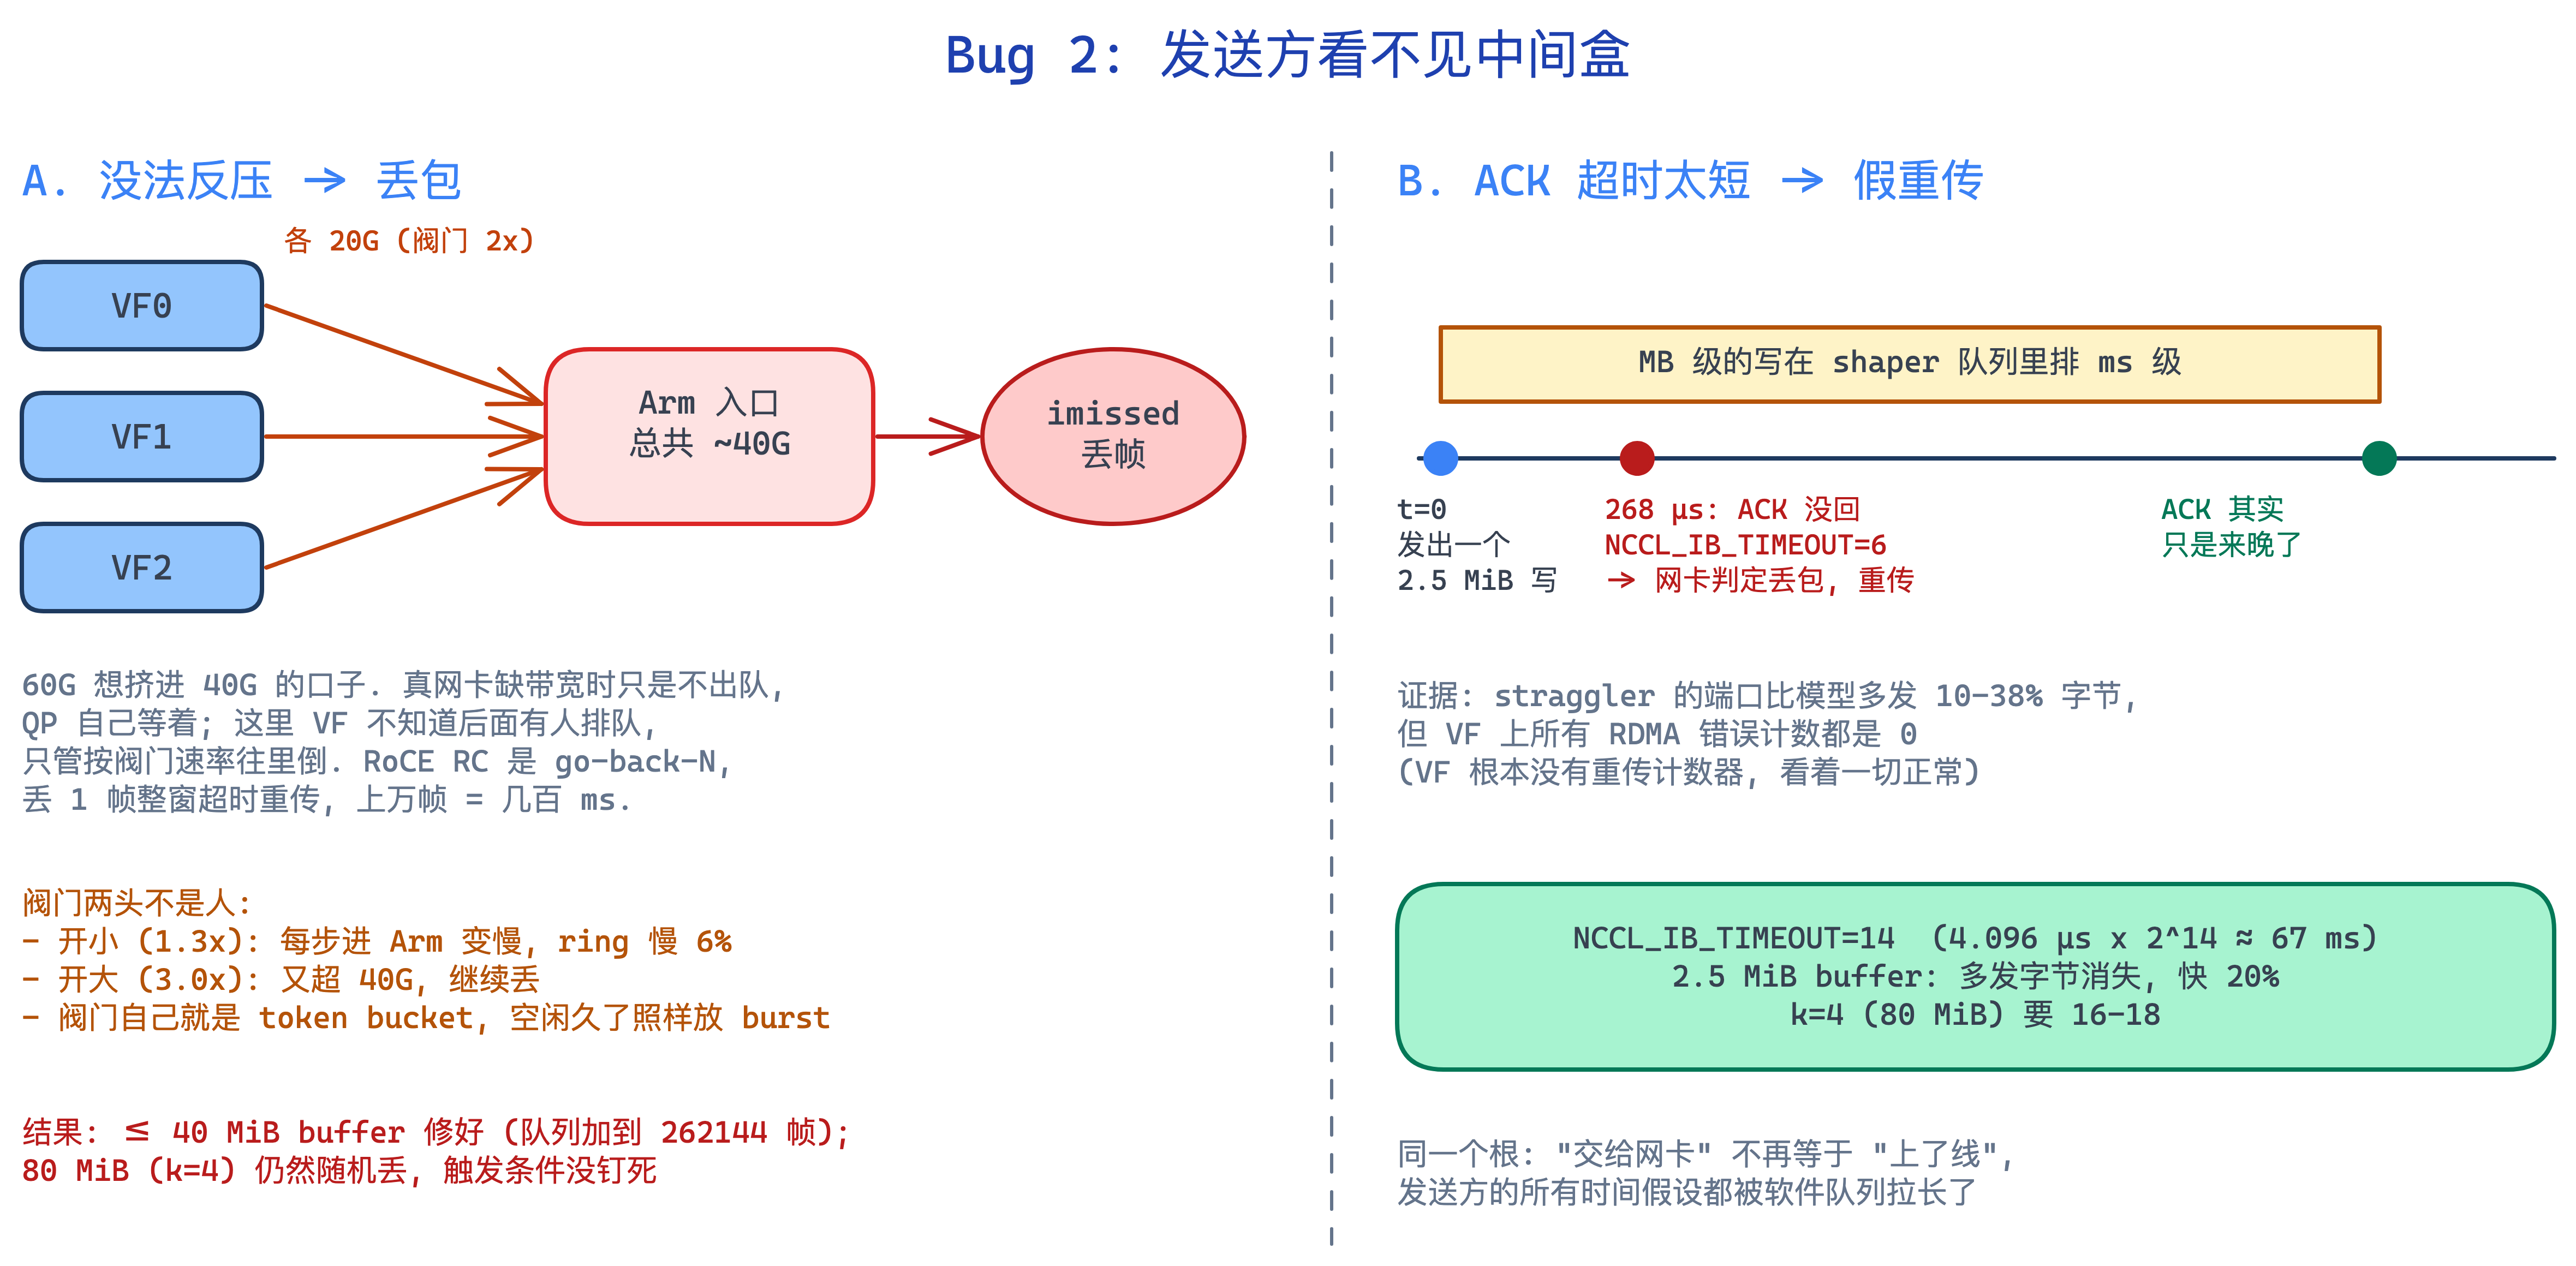
没法反压
先把一个帧从 NCCL 到线上要排的队列摆出来:
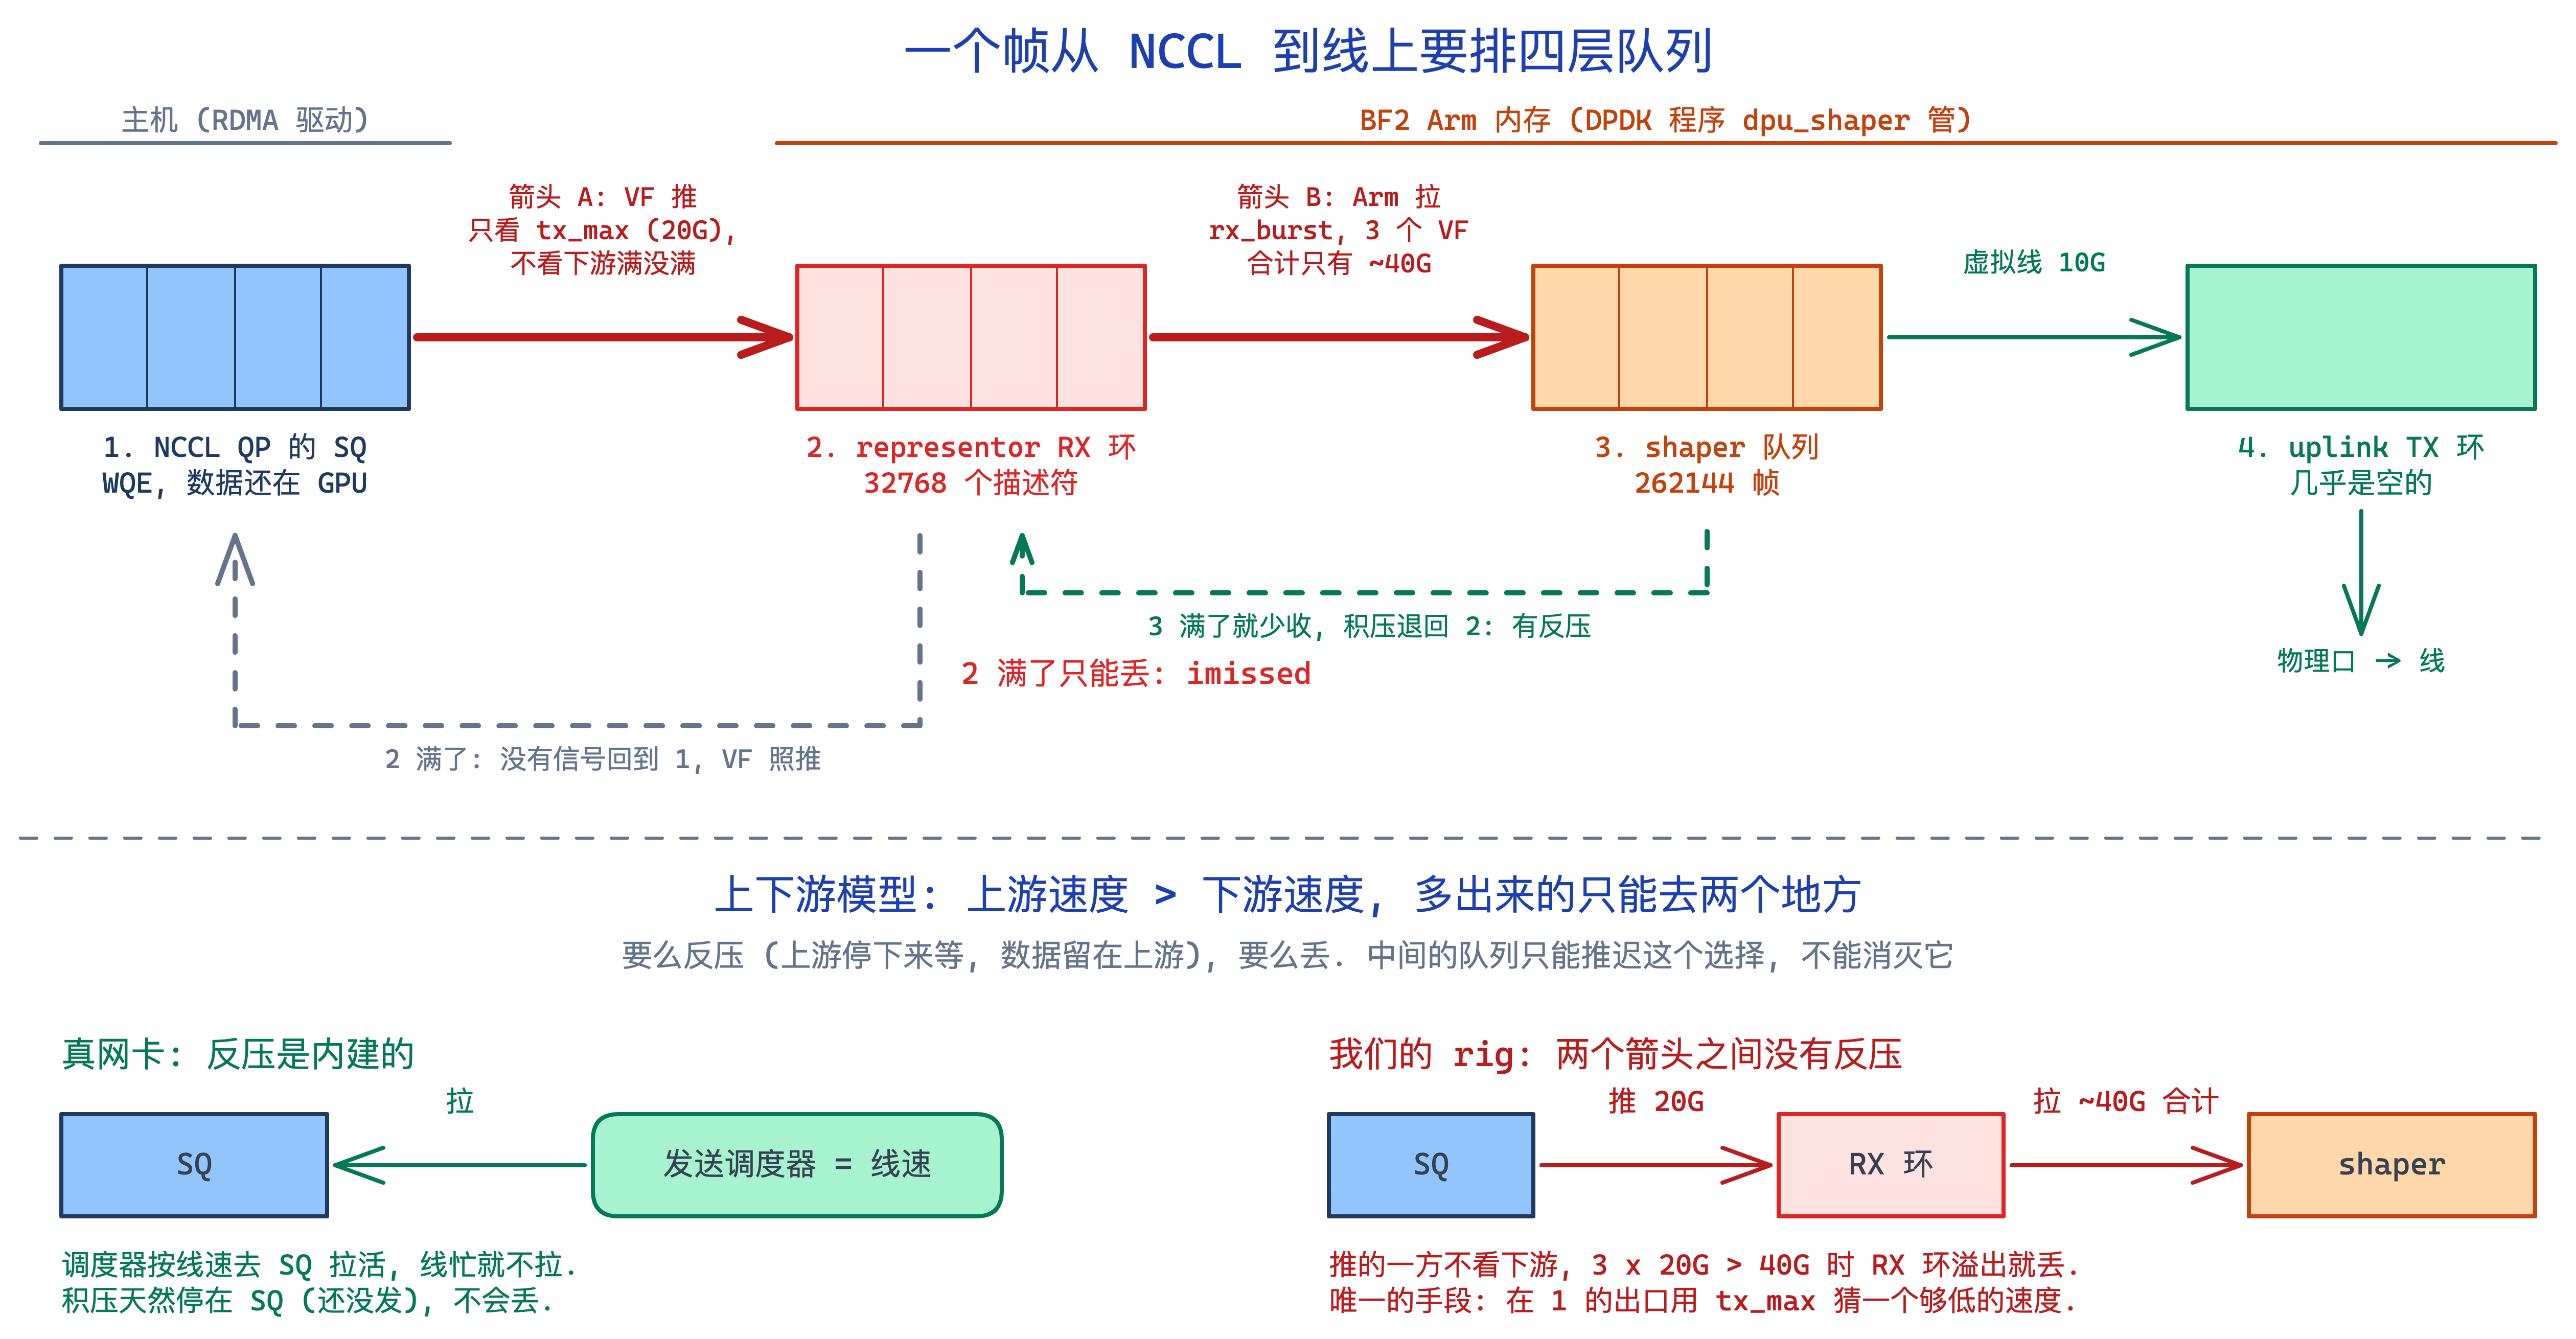
- NCCL QP 的 SQ (主机内存):
ibv_post_send贴进来的 WQE, 数据还在 GPU 里. 由 VF 的发送调度器消费. - representor 的 RX 环 (Arm 内存, 32768 个描述符): VF 已经 “发出”, eSwitch 送到了 Arm, 但 dpu_shaper 还没
rx_burst收走的帧. - shaper 队列 (Arm 内存, 262144 帧): 收进来了, 在等虚拟线上自己的出发时刻.
- uplink 的 TX 环:
tx_burst交给网卡, 以物理线速发出. shaper 按 10G 往里放, 所以它几乎是空的.
注意 1 和 2 之间, 2 和 3 之间的两个箭头, 方向一样, 驱动方式却不一样:
- 箭头 A 是 “推”. VF 不归 DPDK 管, 它的调度器只看
tx_max阀门 (20G) 和 eSwitch 的内部带宽 (约 100G), 完全不知道 Arm 那边满没满. - 箭头 B 是 “拉”. dpu_shaper 在 Arm 上
rx_burst, 一块 Arm 收包合计只有约 40G, node0 上 3 个 VF 各推 20G 就是 60G.
这里有一个很朴素的上下游模型: 上游速度 > 下游速度时, 多出来的数据只能去两个地方, 要么反压 (让上游停下来等, 数据留在上游), 要么丢. 中间加队列只能推迟这个选择, 不能消灭它.
拿这个模型对一下:
- 3 到 2 之间有反压: shaper 队列满了就少收, 积压退回 RX 环.
- 2 到 1 之间没有: RX 环的空 mbuf 用光时, eSwitch 不会让 VF 暂停 (PFC / PAUSE 只管物理口和交换机之间那一跳, 管不到网卡内部), 新来的帧没地方放, 网卡直接丢, 记作
imissed.
真网卡为什么没这个问题? 因为它的调度器是按线速去 SQ 拉活的, 线忙就不拉, 积压天然停在 SQ 里, 是 “还没发”. 我们的 VF 把积压搬进了 Arm, 变成了 “发了但没上线”, 于是同样的速度差在真网卡上是反压, 在这里就是丢包. RoCE RC 是 go-back-N, 丢一帧整窗重传, 上万帧就是几百 ms.
能用的手段只剩在箭头 A 的起点用 tx_max 猜一个够低的速度, 开小了每步进 Arm 太慢, ring 慢 6%; 开大了接着丢, 而且阀门自己也是 token bucket. 最后 40 MiB 以下的 buffer 靠加大 shaper 队列修好 (Arm 总有地方放, 丢包只剩 Arm 收不动这一种原因), 80 MiB 那一档仍会随机丢, 只认 0 丢包的运行.
假重传
buffer 一大, 慢节点就比模型多发 10-38% 字节, 但 VF 上 RDMA 错误计数全是 0. 原因是 NCCL_IB_TIMEOUT=6 的 ACK 超时只有约 268 µs, 而 MB 级的写在 shaper 里要排毫秒级, ACK 只是来晚了, 网卡却重传整段 (VF 上没有重传计数器, 所以看不出来). 改成 14 (约 67 ms) 后多发的字节消失, 还快了 20%.
Bug 3: 追赶深度给多少都不对
shaper 能用了, 但裸 RDMA 跑 10G 只有 9.18G, ring 只到理想时间的 1.17 倍.
原设计里空闲后线最多领先现实 depth = 2 帧, 本意是不攒额度. 但 Arm 轮询偶尔晚到, 这段时间帧其实已经到了, 真线早就发出去了, shaper 却只许追回 2 帧, 剩下的线时间永久丢失.
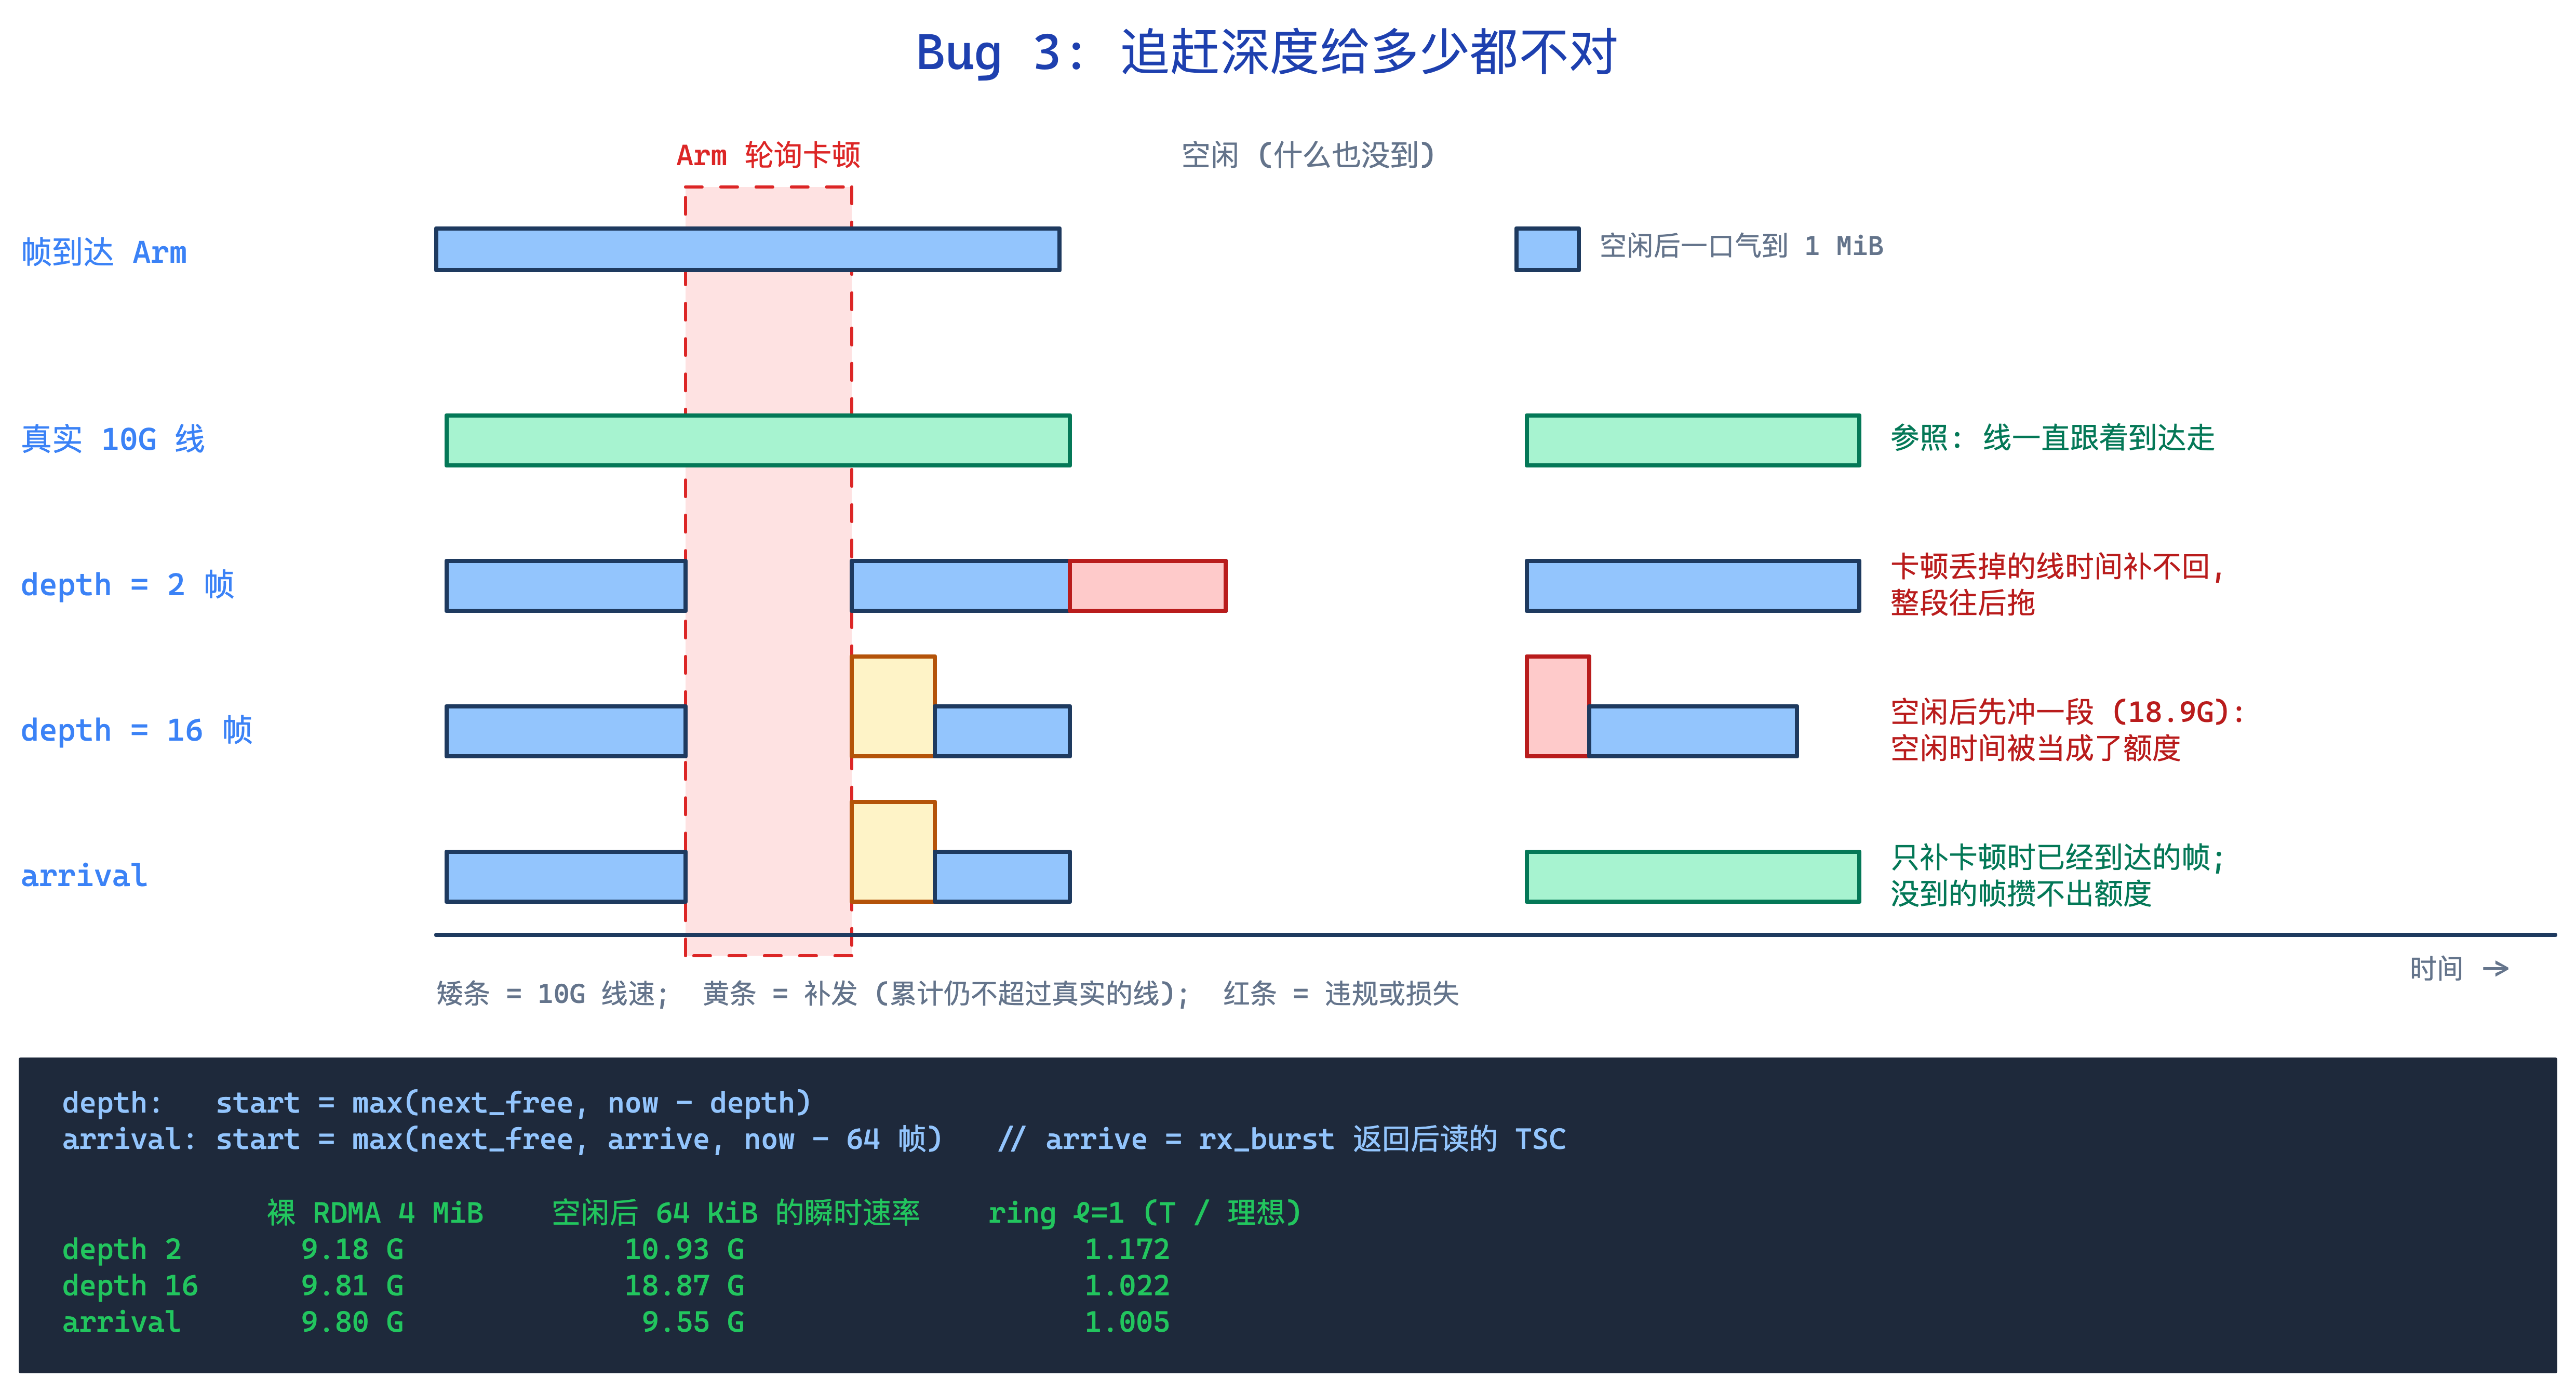
把 depth 加到 16 帧, 线速跑满了, 但空闲后先冲到 18.9G, 等于在 shaper 里重新发明 token bucket, 否掉. 最终给每帧盖到达时间戳, 出发时刻改成:
1 | start = max(next_free, arrive, now - 64 帧) |
卡顿期间已到达的帧可以补发 (真线这时本来就在发它们), 累计发出量永远不超过一根真线面对同样到达序列的量; 线空着时没有帧到达, 也就攒不出额度 (空闲后实测 9.55G); now - 64 帧 只防 Arm 卡太久一下子放太多. 结果裸 RDMA 9.80G 满速, ring 1.172 倍降到 1.005 倍. 代价是旧 shaper 上的好几个结论其实来自 ring 被拖慢, 全部作废重做.
Bug 4: 两个 QP 撞进同一个子队列
跑 MSCCL++ 时, 同一配置一会儿快一会儿慢 (双峰), 慢的时候伴随上千个重复包, Arm 丢帧却一直是 0.
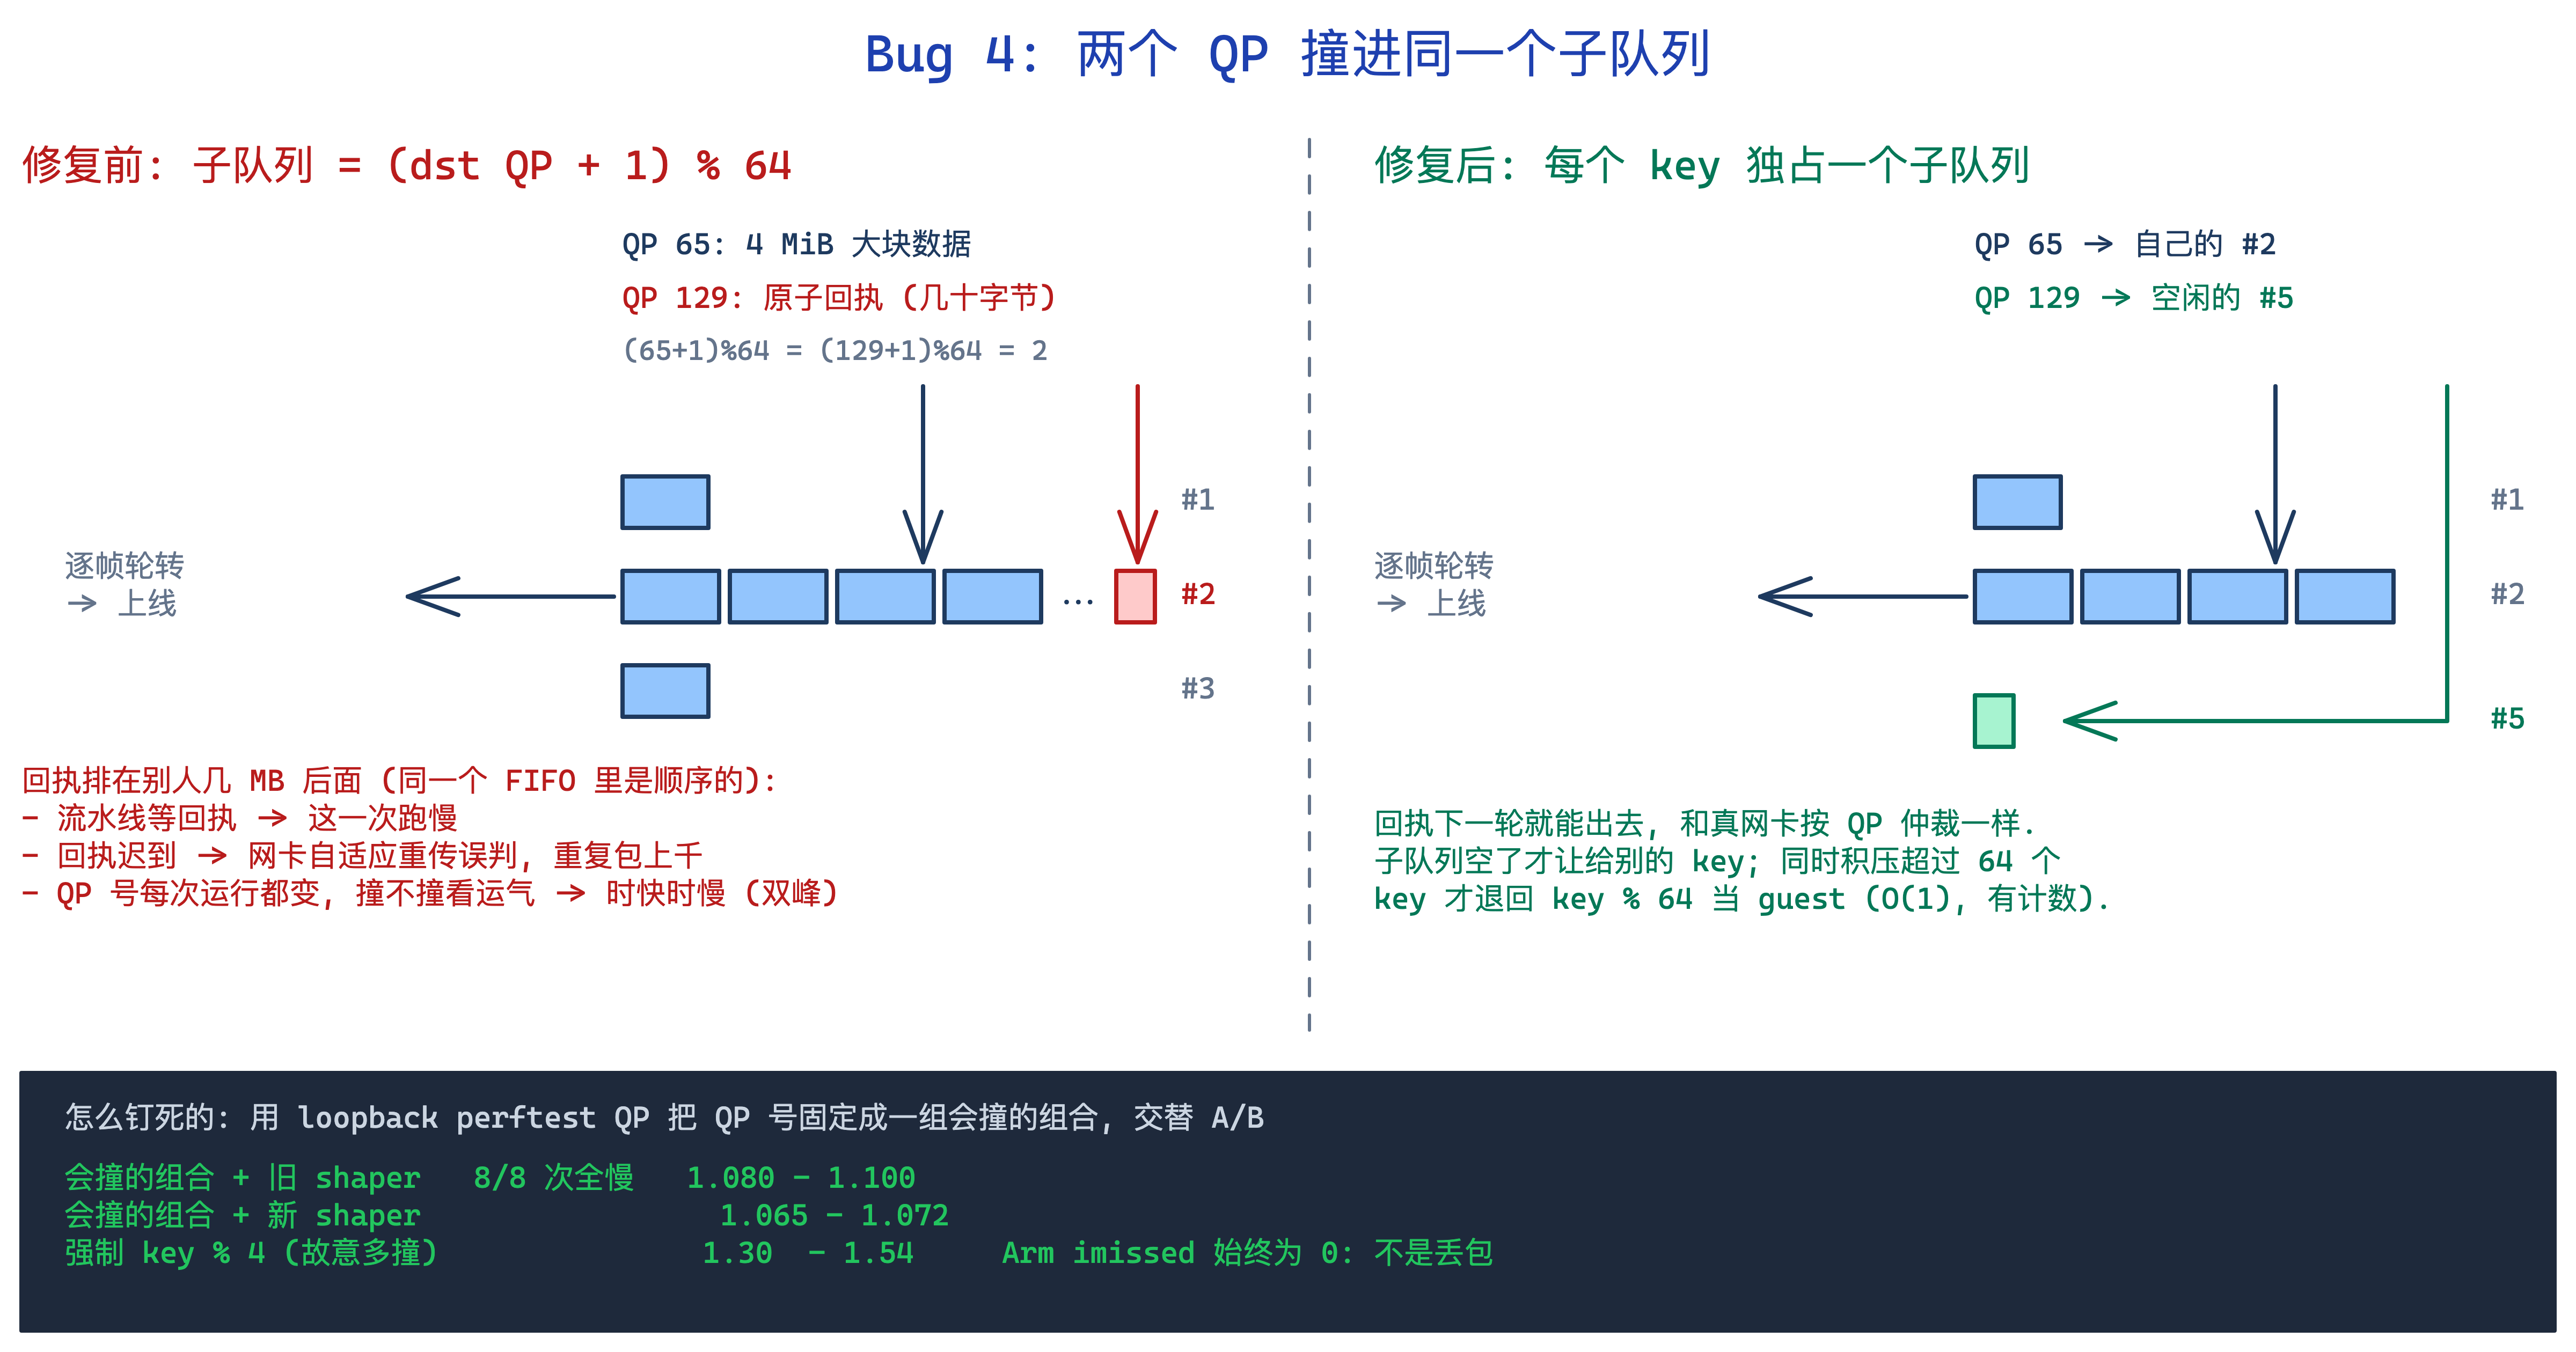
问题出在 bug 1 的子队列: 编号 = (目的 QP + 1) % 64, 两个 QP 号差 64 的倍数就撞进同一个 FIFO, 几十字节的原子回执排在别人几 MB 后面. 流水线等回执就慢了, 回执迟到又让网卡自适应重传误判, 出现重复包. QP 号每次运行都变, 撞不撞看运气, 所以是双峰.
验证方法是用 loopback perftest QP 先占掉 QP 号, 把 NCCL 的 QP 固定成一组必撞的组合交替 A/B: 旧版 8 次全慢, 新版全快; 故意改成 key % 4 让它多撞, 直接慢到 1.3-1.5 倍. 修法是每个 key 独占一个子队列, 空了才让给别人, 同时积压超过 64 个 key 才退回取模. 真网卡本来就按 QP 仲裁, 这只是让 shaper 更像真网卡.
回头看
四个 bug 的根是同一个: 限速从网卡调度器搬到了发送方看不见的软件中间盒. 于是 RTT 被拉长 (ECE, ACK 超时), 没有反压 (丢包), QP 仲裁得自己重写 (FIFO, 子队列冲突).
修的时候一直用同一把尺子: 一块真实的物理网卡会怎么做. 没有突发额度, 发送调度器不丢包, 按 QP 仲裁. 每次改动都是补 shaper 和真网卡的差距, 不是为了让某个算法跑得更快, 反过来为了结果好看去调 shaper 就是作弊. shaper 每改一次, 旧数据整体作废.
还没收尾的: 80 MiB buffer 的随机丢包没查清; 按目的 IP 限速, 运行时改速率, 在 Arm 上打 ECN 让真正的 DCQCN 降速, 这几个只讨论过没做.