NCCL 初始化与连接建立
先区分 topo, graph, channel 和 connection
NCCL 建立连接的主线可以记成 发现硬件 → 搜索通信图 → 拼出各 channel 的逻辑邻居 → 为邻居建立 transport 连接. 建立好之后, collective kernel 和 proxy 才沿着这些连接推进数据.
例如两台机器各有两个 rank. NCCL 先知道 GPU 和 NIC 如何连接, 再为某个 channel 选出节点内顺序 [0, 1] 和 [2, 3], 将两段拼成 0 → 1 → 2 → 3 → 0. 此时 rank 1 知道自己的 prev = 0, next = 2. 随后再分别为这两条边准备本地 GPU 通路或跨机网络通路.
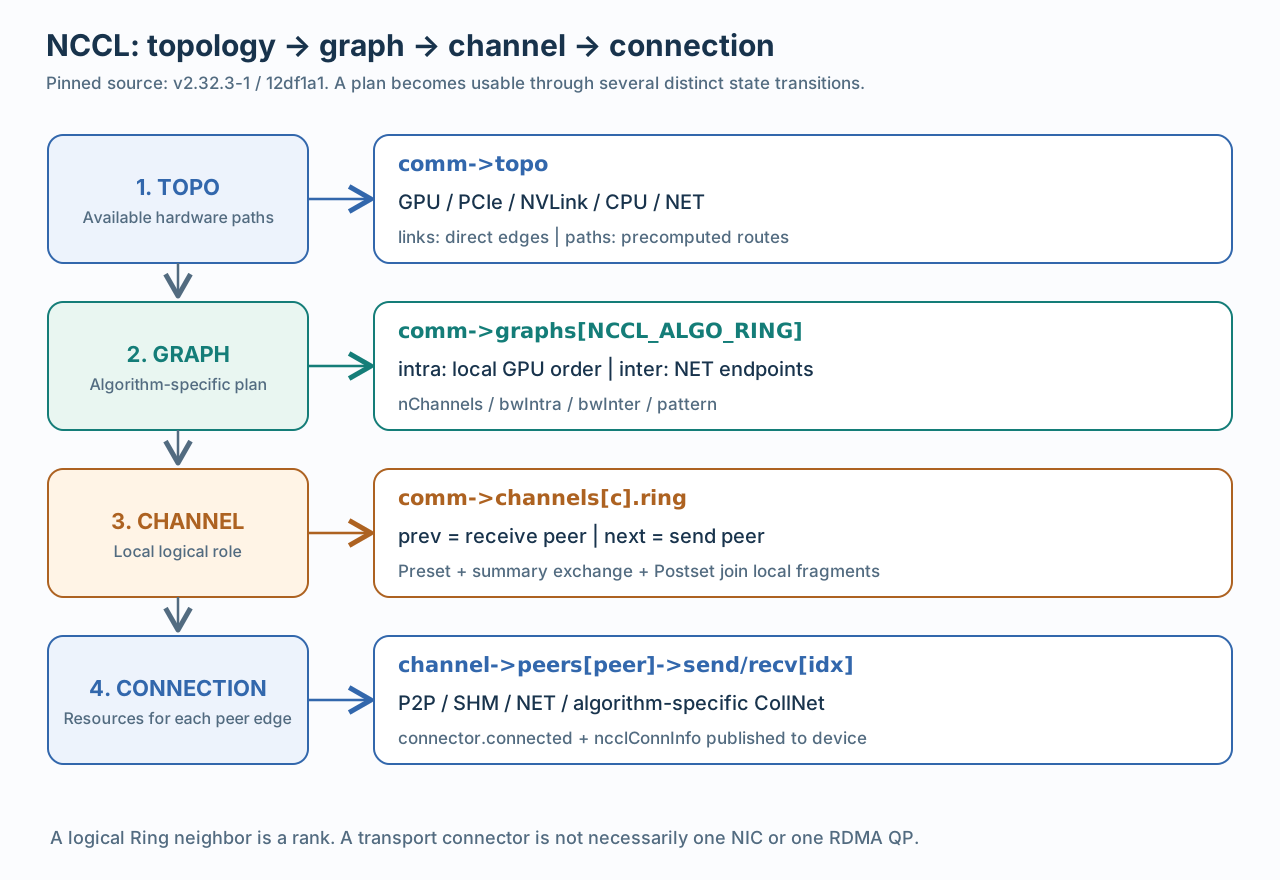
| 抽象 | 回答的问题 | 典型数据 |
|---|---|---|
| Topo system | 硬件有哪些, 两个资源之间能怎么走 | comm->topo, ncclTopoNode, links, paths |
| Algorithm graph | 为某种算法选哪些 GPU 顺序, 网络端点和 channel 数 | comm->graphs[], intra, inter, nChannels |
| Channel | 当前 rank 在这条并行通信通道中和谁收发 | comm->channels[c], ring.prev/next, tree.up/down |
| Transport connection | 这条 peer 边通过什么资源实际搬数据 | peers[peer]->send/recv, ncclConnector, ncclConnInfo |
这里的 graph 指拓扑搜索产生的算法通信图, 与 CUDA Graph 是两个概念. 一个 channel 可以包含 Ring, Tree 等算法的逻辑信息; 它也不是一个固定大小的数据块, 更不能直接等同于一个 NIC 或一个 RDMA QP.
本文固定对照 NCCL v2.32.3-1, commit 12df1a1, 以普通跨节点 Ring, SIMPLE 协议和 CPU proxy 驱动的 NET/IB 路径为主. NVLS, CollNet 等分支只在需要区分概念时提及. 文中尺寸来自该版本的默认值, 图中的 rank 顺序是说明流程的例子. 源码版本.
初始化的执行顺序
应用或启动器提供相同的 ncclUniqueId, 每个参与者自己的 rank, 以及统一的 nranks. NCCL 再交换信息, 计算连接方案. 因而 应用指定的 rank 编号和NCCL 搜索出的 Ring 顺序需要分开.
省略参数检查, 内存管理和部分特殊硬件分支后, 主要调用关系如下:
1 | ncclCommInitRank |
bootstrap 提供初始化期间的信息交换通路. 搜索和连接过程中, NCCL 还会使用它交换拓扑摘要和连接描述. Bootstrap Ring 与最终搬运 collective 数据的 Ring 不必相同. 初始化主流程.
Topo system 保存硬件和路径
ncclTopoGetSystem() 生成 comm->topo, 类型为 ncclTopoSystem*. 对普通多机系统, 可以先把它理解成当前计算域内的硬件视图: GPU, PCIe switch, CPU/NUMA, NVLink/NVSwitch, NIC 和网络设备等资源如何相连.
其中几个结构需要分开:
| 结构或字段 | 含义 |
|---|---|
ncclTopoSystem::nodes[type] |
按资源类型组织的节点集合 |
ncclTopoNode::type, id |
节点的类型和拓扑标识, id 不一定是 communicator rank |
ncclTopoNode 中的 union |
GPU, NET, CPU 等类型各自的属性, 如 gpu.rank, net.dev, net.port |
ncclTopoNode::links[] |
从该节点直接连接出去的硬件边 |
ncclTopoLink |
一条直连边的 type, bw, remNode |
ncclTopoNode::paths[type] |
预计算的到目标资源的路径表 |
ncclTopoLinkList |
某条路径的链路列表, 跳数 count, 瓶颈带宽 bw, 路径类型 type |
ncclTopoSystem::maxBw, totalBw |
graph 搜索使用的带宽上界与预算信息 |
NIC 节点和 NET 节点也不宜混为一谈. 可以先将前者看作物理网卡相关的拓扑位置, 后者看作网络后端暴露的可用网络设备或端口; graph 里的 inter[] 记录的是 NET 拓扑 ID. 拓扑结构.
links 是直连边, paths 是组合路径
假设 GPU0 到 NIC0 需要经过一个 PCIe switch. links 描述每一段直接连接, paths 则保存从 GPU0 走到 NET0 的整条路径及其属性.
ncclTopoComputePaths() 会计算这些可复用路径, 并结合 P2P, GDR 等能力处理可用性. 这里不能只理解成普通最短路: 该版本的路径更新首先比较路径类型, 同类型再偏好较高带宽, 类型和带宽相同再偏好较少跳数. 路径带宽取沿途链路带宽的最小值. 路径计算与比较.
源码中常见的 PATH_NVL, PATH_PIX, PATH_PXB, PATH_PHB, PATH_SYS, PATH_PXN 等, 用于区分 NVLink, PCIe switch, host bridge, NUMA/系统互连或经中间 GPU 到 NIC 等路径类别. 它们描述资源之间的通路, 还没有决定整个 collective 的 rank 顺序.
Graph 把硬件路径变成算法方案
ncclTopoCompute(comm->topo, graph) 接收拓扑和搜索约束, 产出某种算法可用的通信方案. 初始化阶段会为 Ring, Tree 等分别准备 graph.
以 ringGraph 为例, 经典字段如下:
| 字段 | 在这里如何理解 |
|---|---|
id |
graph 自己的标识, 不等同于 NCCL_ALGO_* 枚举值 |
pattern |
搜索形状, 如 NCCL_TOPO_PATTERN_RING |
minChannels, maxChannels |
输入的 channel 数约束 |
nChannels |
graph 搜索得到的 channel 数 |
intra[c * ngpus + i] |
channel c 在当前拓扑域中的第 i 个 GPU rank |
inter[2*c], inter[2*c+1] |
channel c 选择的两端 NET 拓扑 ID |
bwIntra, bwInter |
搜索方案的节点内与跨节点带宽参数, 单位为 GB/s |
typeIntra, typeInter |
搜索方案使用的路径类别 |
sameChannels |
是否约束多个 channel 使用相同的路径安排 |
crossNic |
是否允许或尝试跨不同 NIC/rail 的安排 |
nHops |
比较候选方案时使用的跳数统计 |
这些字段在该版本叫 bwIntra/bwInter, 阅读旧版本时可能遇到 speedIntra/speedInter. comm->graphs[NCCL_ALGO_RING] 按算法枚举索引, 而初始化中 Ring graph 的 id 设为 0; 两者不能互换. Graph 定义, Ring graph 初始化.
对于跨机 Ring, 一条 graph 路径可以先想成:
1 | 入口 NET → 本节点 GPU rank 顺序 → 出口 NET |
它已经选择了本地网络端点, 但尚未保存一个覆盖全世界 rank 的完整 Ring, 也没有创建这些边对应的全部 QP 和 transport 资源.
ncclTopoCompute 在搜索什么
搜索会尝试 GPU 顺序, NIC 选择, channel 安排以及带宽和路径类别约束. 递归过程中检查路径能否承载当前方案, 分配相应带宽预算, 失败时回退, 再尝试其他安排.
search: 和 done: 是这套控制流程中的标签. 找不到足够好的方案时, 会改变 sameChannels, 路径约束, crossNic, 或从 speedArray 中降低尝试的带宽档位. 得到方案后, 还可能复制 channel 或继续尝试提高带宽.
候选比较会考虑 channel 数与带宽的组合, 再考虑跳数等条件. 搜索受时间预算和启发式限制, bwIntra/bwInter 是规划参数, 不能当作实际运行的带宽测量. 搜索入口, 候选比较.
Preset 和 Postset 拼出全局逻辑环
Preset 提取节点内邻居和边界
ncclTopoPreset() 读取 graph 的 intra[], 为每个 rank 整理节点内的前后关系, 并填充 ncclTopoRanks:
ringRecv[c]: 本节点这一段 Ring 的入口 rank.ringSend[c]: 本节点这一段 Ring 的出口 rank.ringPrev[c],ringNext[c]: 当前 rank 的节点内前驱和后继; 在本地片段边界处先记为 -1.treeToParent/Child0/Child1: Tree 拼接需要的边界 rank 信息.
随后 topoRanks 与各算法的 graphInfo 一起放入 allGather3Data, 通过 bootstrapAllGather() 交换. 交换的是这些摘要和连接所需信息, 不是简单地 AllGather 整个 ncclTopoSystem. Preset, 摘要交换.
各节点的硬件能力和搜索结果可能不同. 初始化代码会根据交换结果收紧方案, 例如对 graph 的 nChannels, bwIntra, bwInter 取较小值, 对 typeIntra/typeInter 取较大的路径类别值, 再进入 Postset. 因而最后使用的配置还要满足各参与者共同的约束. Graph 参数对齐.
Postset 连接各节点的片段
仍以一个 channel, 两台机器, 每机两个 rank 为例:
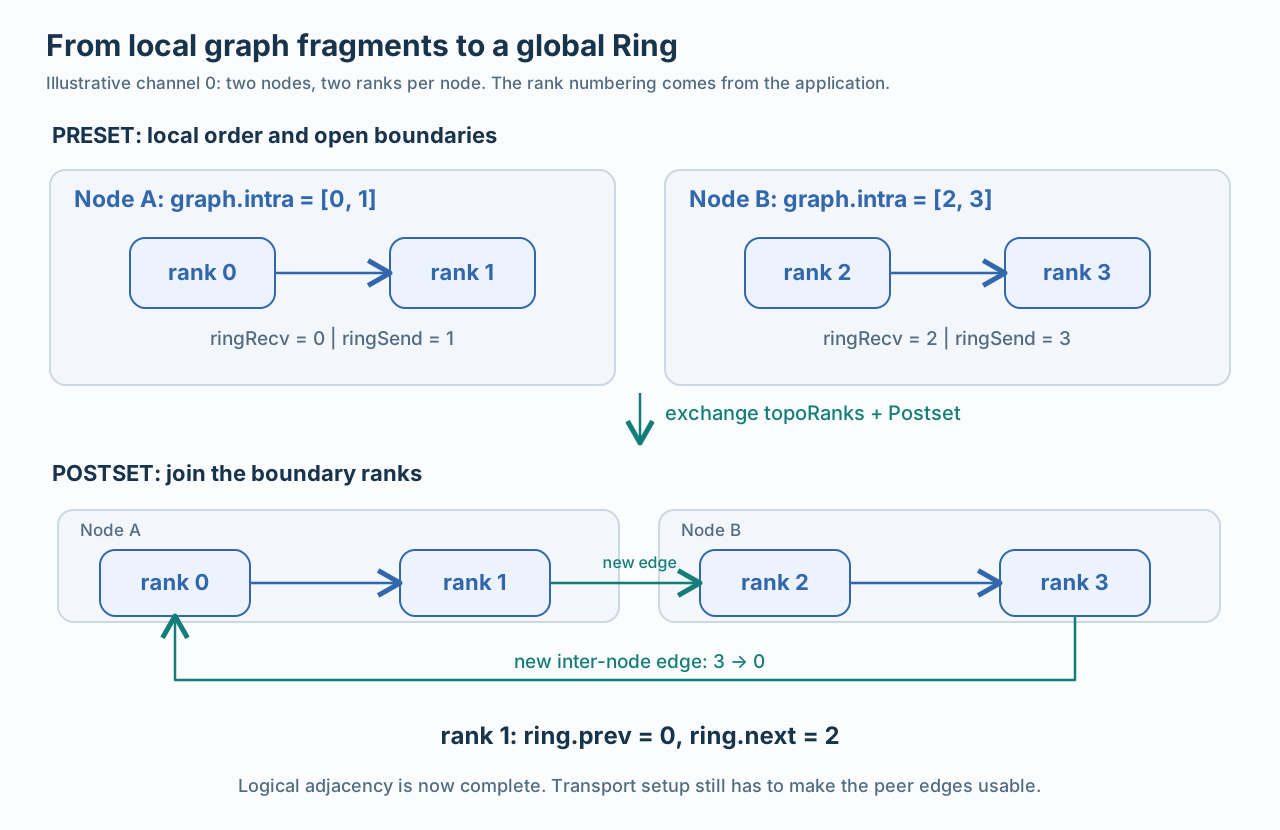
节点 A 的 graph 给出 [0, 1], 节点 B 给出 [2, 3]. Preset 后得到:
| Rank | 本地 prev | 本地 next | 所在节点的入口和出口 |
|---|---|---|---|
| 0 | -1 | 1 | 入口 0, 出口 1 |
| 1 | 0 | -1 | 入口 0, 出口 1 |
| 2 | -1 | 3 | 入口 2, 出口 3 |
| 3 | 2 | -1 | 入口 2, 出口 3 |
ncclTopoPostset() 中的 connectRings() 将前一节点的出口接到本节点入口, 将本节点出口接到下一节点入口. 在这个例子中补上 1 → 2 和 3 → 0, 得到:
1 | rank 0: prev = 3, next = 1 |
最终结果写进各 rank 的 comm->channels[c].ring.prev/next. 这里的 connect 是拼接逻辑邻接关系, 尚不是建立 IB QP. Postset 还处理 Tree, channel 复制及数量限制等, 所以最初 graph 的 nChannels 与最终 comm->nChannels 也不一定完全相同. 逻辑 Ring 拼接, Postset.
Channel 记录逻辑顺序和 peer 连接
comm->channels[c] 中的 ring 保存 Ring 信息, tree 保存 Tree 信息, peers[peer] 则提供与对应 peer 的发送和接收 connector.
| 字段 | 含义 |
|---|---|
comm->rank, comm->nRanks |
当前 communicator 的全局 rank 与 rank 总数 |
comm->localRank, comm->localRanks |
当前节点内的 rank 编号与数量 |
comm->node, comm->nNodes |
当前节点编号与节点总数 |
comm->nChannels |
初始化整理出的 channel 数 |
comm->p2pnChannels |
Send/Recv 点对点调度使用的 channel 数, 需与 collective channel 概念分开 |
channel->ring.prev/next |
当前 channel 的逻辑前驱与后继 |
channel->ring.userRanks[] |
从当前 rank 开始排列的 Ring 顺序, 元素仍是用户 rank |
channel->ring.rankToIndex[] |
userRanks[] 的逆映射 |
channel->ring.index |
当前 rank 在以 rank 0 为基准的 Ring 中的位置 |
channel->tree.up/down[] |
Tree 的父节点和子节点 |
channel->peers[peer]->send/recv[connIndex] |
该 channel 与 peer 的某个发送或接收 connector |
setupChannel() 会将完整 Ring 数组旋转成从本 rank 开始的 userRanks[]. 例如全局顺序为 [0,1,2,3] 时, rank 2 的 userRanks 为 [2,3,0,1], ring.index = 2. 旋转表示顺序, 不会改变应用提供的 rank 编号. Channel 结构, Ring 结构, setupChannel.
Transport 将逻辑边落实为可用连接
P2pConnect 标记, P2pSetup 建立
ncclTransportRingConnect() 遍历 channel, 对 ring.prev 标记接收连接, 对 ring.next 标记发送连接, 然后调用 ncclTransportP2pSetup().
ncclTransportP2pConnect() 主要更新两个待连接位图:
1 | comm->connectSend[peer] 的第 c 位 = channel c 需要向这个 peer 建立发送连接 |
例如 channel 0 和 channel 2 都需要向 rank 2 发送, connectSend[2] 中相应两位为 1, 即二进制 0101. 位图里的位表示 channel, 不是 QP, chunk 或 NIC 编号.
ncclTransportP2pSetup() 再完成以下工作:
- 对待连接边调用
selectTransport(). - 调用所选 transport 的
setup()准备本地资源和ncclConnect连接描述. - 通过 bootstrap 与对端交换连接描述.
- 调用 transport 的
connect(), 直到这条边完成连接. - 设置
connector->connected = 1, 将ncclConnInfo复制到 GPU 可见的 peer 结构.
这里函数名里的 P2p 是 peer 连接管理的含义. 它不表示每条边都必然采用 CUDA P2P transport. Ring 连接入口, 连接位图与 setup.
Transport 选择与 GDR
该版本的普通选择逻辑按 P2P → SHM → NET → CollNet 的顺序调用 canConnect(), 选择第一个满足条件的 transport. 这描述的是源码的能力检查顺序, 并非每种 collective 都依次尝试四条数据路径.
| Transport | 主要作用 |
|---|---|
| P2P | 通过 CUDA peer access, IPC 等机制访问 peer GPU, 底层可能走 NVLink 或 PCIe |
| SHM | 使用主机共享内存完成本机进程之间的数据传递 |
| NET | 使用网络后端, 如内置 IB/RoCE 后端或 Socket 后端 |
| CollNet | 面向支持集合通信能力的网络后端, 由相应算法路径使用 |
因此 P2P transport 不应直接解释成 GPUDirect RDMA, NET 也不必然是 RDMA. GPUDirect RDMA 描述的是 NIC 直接访问 GPU 内存的能力. 在本文的 CPU proxy 路径中, CPU 仍通过网络后端提交工作; GPU 写数据和发布进度, NIC 可以直接读取 GPU buffer. 是否经过 host staging, 取决于实际 transport, GDR 支持和注册路径. Transport 选择.
Connector 和 ConnInfo
ncclConnector 保存主机侧的 connected, transportComm, transportResources, proxyConn 等信息. 其中嵌入的 conn, 类型为 ncclConnInfo, 提供 GPU 通信原语需要的状态:
buffs[protocol]: 各协议使用的 buffer.head,tail: 生产消费进度与可复用空间的同步位置.step,stepSize: 当前进度和 SIMPLE buffer 的 step 大小.connFifo: GPU 与 proxy 交换 size, offset 等信息的 FIFO.flags,ptrExchange: 直接访问能力和指针交换等信息.
一个 connector 是 NCCL 的逻辑连接对象, 不能直接当作一个 RDMA QP. 后端可能共享资源, 也可能使用多个 QP 或设备完成一次请求. Connector 与 ConnInfo.
初始化结束时, 哪些连接已经建好
该版本使用 comm->runtimeConn = comm->cuMemSupport && ncclParamRuntimeConnect() 判断运行时连接路径. 满足条件且 NCCL_RUNTIME_CONNECT=1 时, 部分算法数据连接会推迟到首次需要时建立. 非运行时连接分支则在初始化阶段调用 Ring, Tree 等连接函数.
因此测量时要区分初始化, 首次算法连接, warmup 和稳态通信. 图和 channel 已经确定, 不意味着所有后续 collective 用到的数据边都已完成连接. 初始化分支, 首次使用时的连接.
Buffer, step, slice 和 chunk 的大小
连接建立后, 数据沿 channel 被分段和流水处理. 以下只看默认 Ring AllReduce + SIMPLE 的基础尺寸, 不将注册 buffer, 共享 buffer 和调优后的所有路径都套进同一个大小.
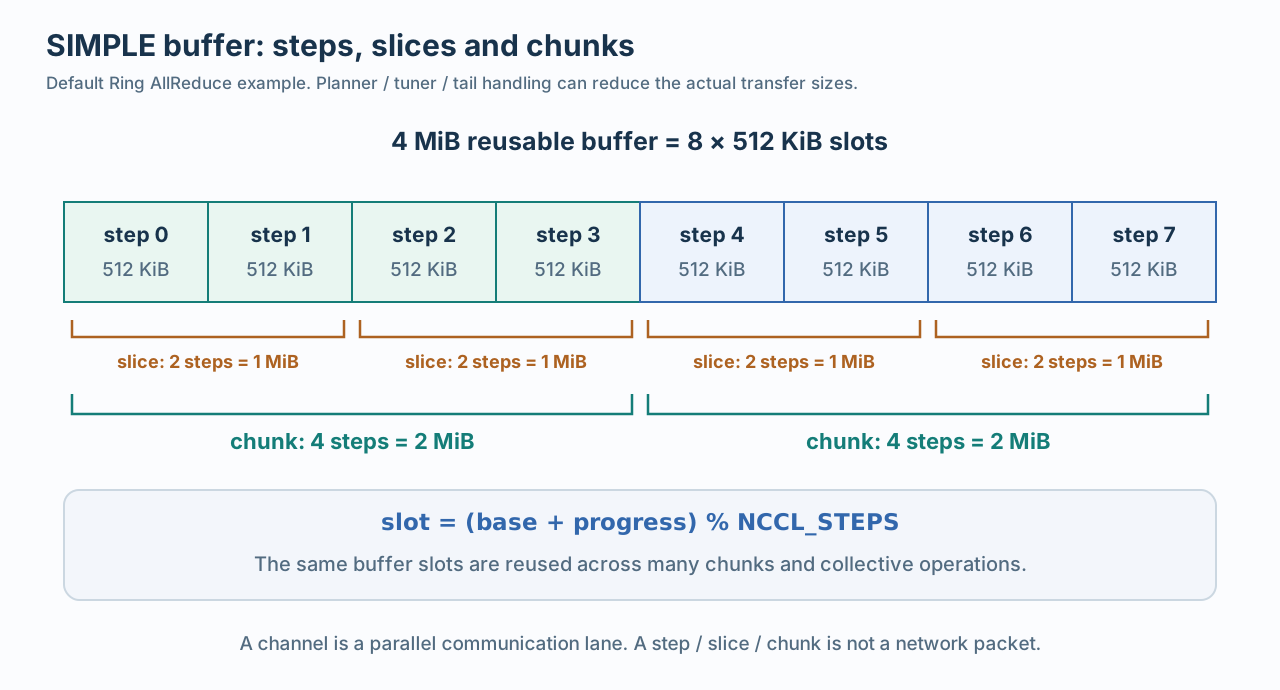
该版本的默认值为:
1 | comm->buffSizes[NCCL_PROTO_SIMPLE] = 4 MiB |
所以这里的 4 MiB 是整个可复用 SIMPLE buffer 的默认容量, 不是一个 chunk 的固定大小. 实际 chunk/slice 还会受消息大小, planner, tuner, 对齐和尾部处理影响.
step 是 buffer 槽位和流水进度的计数单位. 在简单环形 buffer 模型中, 通过 (base + progress) % NCCL_STEPS 找到复用的槽位. 一个 slice 可以覆盖多个 step, 也可以对应一个网络 request; NIC 还会按网络 MTU 等条件分包, 因而一个 step 或 slice 都不是一个固定的线上的 packet.
Channel 是并行处理的数据通道, 可以重复处理多个 chunk 和多轮任务. 不能用 总数据量 / 4 MiB 直接推出 channel 数. 默认 buffer, step 常量, collective 分片常量, 实际 chunk 计算.
Proxy 的 posted, transmitted 和 done
在 CPU proxy 驱动的 NET 发送路径中, sendProxyProgress() 反复推进请求. ncclProxyArgs 可以包含多个 subs[], nsubs 表示子操作数量. 每个 sub 有自己的连接, channelId, nsteps, 进度和 request 数组; nsubs 不是 slice 数, 也不必然等于 channel 数.
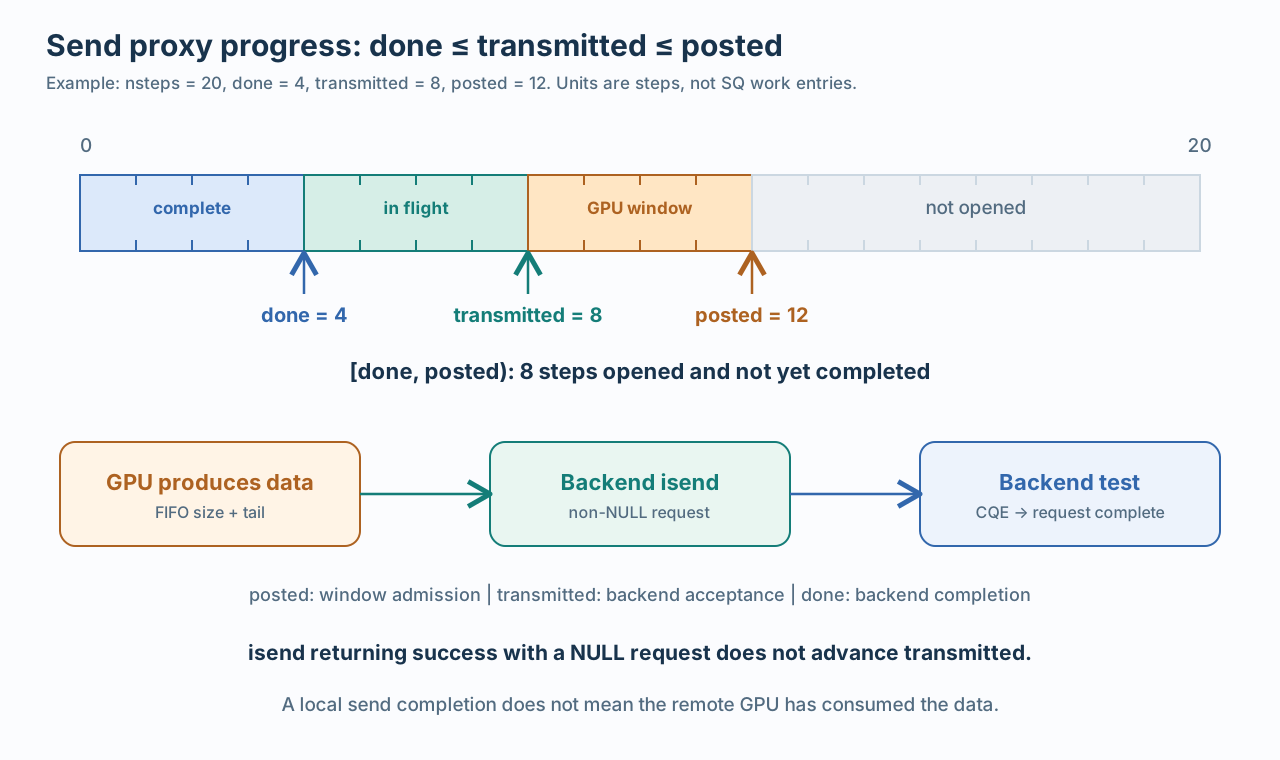
| 字段 | 代表的进度 |
|---|---|
sub->nsteps |
这个子操作总共需要推进多少 step |
sub->base |
本次操作在连接的累计 step 序列中的起点 |
sub->posted |
已纳入发送窗口, 准备让 GPU 生产数据的进度 |
sub->transmitted |
网络后端 isend 已接受并返回 request 的进度 |
sub->done |
后端 test 已确认请求完成的进度 |
sub->requests[slot] |
某个槽位对应的后端异步 request |
args->sliceSteps |
每次 slice 推进的 step 数 |
maxDepth |
当前可开放窗口深度, 受 NCCL_STEPS 和共享资源限制 |
在这条发送路径中, 可以按 done <= transmitted <= posted <= nsteps 理解进度. 例如 nsteps = 20, 当前 done = 4, transmitted = 8, posted = 12, 表示:
1 | [0, 4) 后端已经确认完成 |
这里 nsteps = 20 是总工作量; posted - done = 8 才是此时已开放但尚未完成的范围. 不能将 nsteps 当作窗口大小, 也不能把 proxy 的 posted 理解成已经向 NIC SQ 提交的 WQE 数.
SIMPLE 发送大致经历三段:
- 在窗口允许时推进
posted. 共享 buffer 路径还会发布 buffer offset 和相应进度. - 检查 GPU 发布的
connFifo[slot].size和tail, 确认数据可用后调用ncclNet->isend(). 只有得到非空 request 才推进transmitted; 返回成功但 request 为 NULL 表示本次尚未接受请求. - 调用
ncclNet->test(request, ...). 请求完成后清理 FIFO size, 推进done, 并按该 buffer 路径的规则发布可复用进度.
sendProxyProgress() 一次返回 ncclSuccess 只表示本次推进未报错. 当所有 sub 完成, args->state 才会变为 ncclProxyOpNone. Proxy 状态推进, Proxy 参数结构.
NET/IB 的 isend 最终如何使用 RDMA
isend 是 ncclNet_t 网络后端接口中的函数指针. 选择内置 IB/RoCE 后端时, 它绑定到 ncclIbIsend, test 绑定到 ncclIbTest.
1 | 发送: |
isend 这个名字不表示底层一定使用 SEND opcode
接收端先通过 CTS FIFO 发布可接收的地址, rkey, size, tag 等信息. ncclIbIsend() 检查匹配的接收信息是否就绪; 尚未就绪时可以返回 NULL request, 后续再试.
随后 ncclIbMultiSend() 构造 RDMA WRITE 工作请求, 将 payload 写入接收端发布的地址. 最后的 WR 使用 IBV_WR_RDMA_WRITE_WITH_IMM 和 IBV_SEND_SIGNALED; 批量请求或特定路由条件下, 会将前面的数据 WRITE 与最后的通知 WR 分开. 因而不能将 NCCL 的 isend 接口名直接翻译成 verbs 的 SEND 操作. 后端接口绑定, CTS 检查, WRITE 与 immediate 通知.
RC 的可靠完成和软件调用返回是两回事
本文 NET/IB 主数据路径创建 RC QP. ibv_post_send() 返回成功, 表示工作请求被接受, 并不等待传输完成. RC 通过网卡的可靠传输与确认机制推进; NCCL 后续通过 CQ completion 检查请求是否完成. 所以不能把 RC/UC 的区别记成"RC 的 isend 等 CQE 才返回, UC 提交后就返回". QP 创建, 完成轮询, verbs 提交接口.
普通 RDMA WRITE 不需要为 payload 消费接收端 RQ WQE; WRITE WITH IMM 需要接收 WQE 来承接完成通知. 如果没有合适的接收 WQE, RC 可能遇到 RNR 及重试. 这与交换机出口拥塞是不同问题, 也不代表网卡从 RQ 中取出 payload 的目标地址: WRITE 的目标地址来自 WR 中的远程地址和 rkey. 基础对象与完成通知可结合 RDMA 基础 阅读.
发送 request 完成后, 本地发送 buffer 可以按该请求的完成约定进入复用流程. 但这不说明远端 GPU 已经消费数据. 接收端还需要处理接收完成, 必要的 GPU 可见性/flush, 以及消费进度和 buffer 复用. 本地提交, NIC 完成, 远端 GPU 消费, collective 完成, 分属不同层次.
到这里, 源码的层次就可以连起来: topo 描述可走的硬件路径, graph 选择算法安排, channel 保存本 rank 的逻辑角色, transport 建立可用的 peer 连接, GPU 和 proxy 沿这些连接推进数据. 更底层的 RoCE 封装, ECN/PFC/DCQCN 和重传机制, 还要继续看 provider, NIC 固件和网络设备. 以上是固定版本的源码笔记, 不包含实际集群运行或性能测量.