RDMA 基础
从一次接收理解 RDMA
先把 RDMA 理解成应用和网卡之间的一组队列. 应用提交要做的工作, 网卡执行, 再把执行结果放回完成队列. 实际传输的数据放在提前注册的内存中.
以 A 向 B 发送一条消息为例, B 先准备接收 buffer, 将这段内存注册成 MR, 再往 QP 的 RQ 中提交接收请求. 消息到达后, B 的网卡根据请求把数据写入 buffer, 并向 CQ 写入完成记录. B 的应用取出完成结果后, 就可以处理 buffer 中的数据.
下面主要看普通用户态 RDMA, 使用 RC (Reliable Connection) QP 和 SEND/RECV, 暂不涉及 GPU 显存和共享接收队列.
QP 和 PD 的资源关系
QP 包含 SQ 和 RQ
A 和 B 两端各自创建本地 QP (Queue Pair). 一个 QP 包含两个工作队列:
- SQ (Send Queue): 提交发送方向的工作, 如 SEND, RDMA WRITE 和 RDMA READ.
- RQ (Receive Queue): 提交接收请求, 描述接下来可以往哪里接收数据.
应用构造 WR (Work Request), 通过 ibv_post_send() 或 ibv_post_recv() 提交. provider 将它转换为网卡可以处理的 WQE (Work Queue Element). WR 是应用提交的请求, WQE 是工作队列中的条目. RQ 中放的是接收描述符, 数据本身放在描述符指向的 buffer 中. QP 接口, 接收接口.
PD 划分资源保护范围
PD (Protection Domain) 可以理解为一个 RDMA 设备内部的逻辑保护域. QP 和 MR 都关联到某个 PD, 网卡据此检查 QP 是否可以使用对应的内存资源.
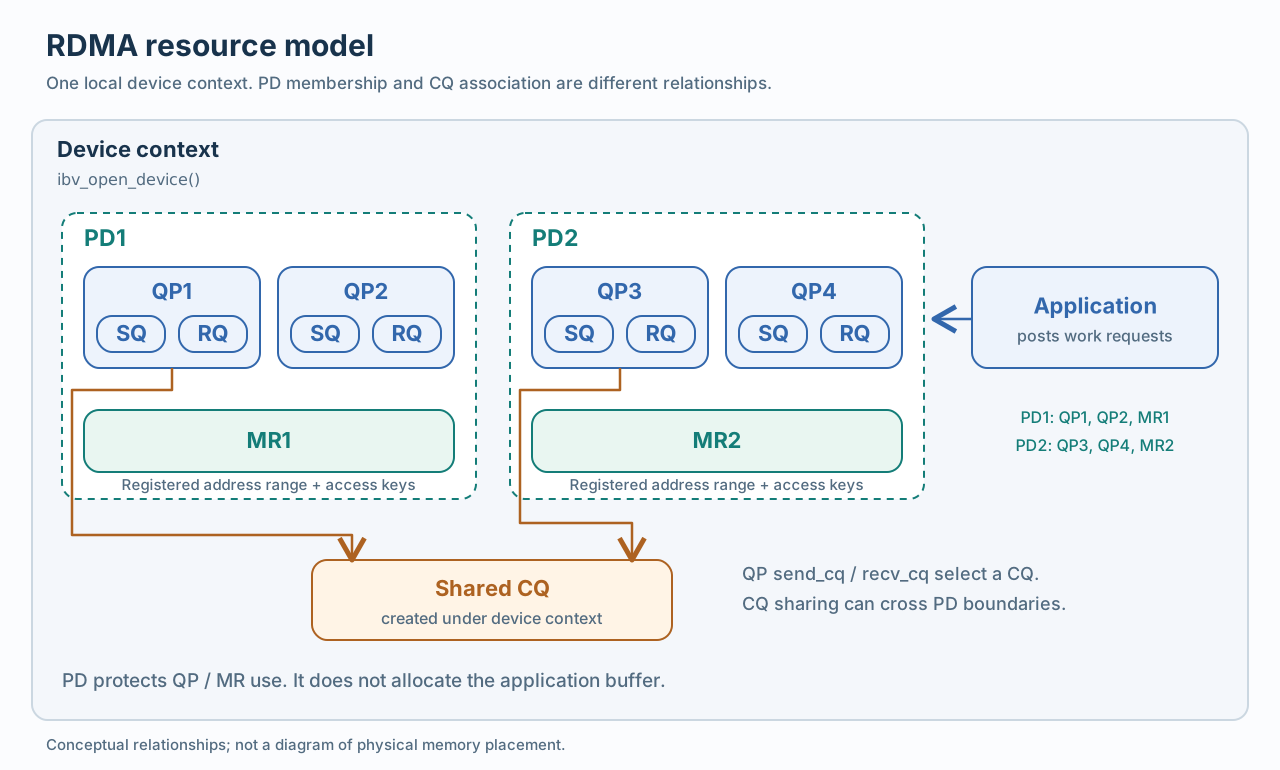
例如, PD1 关联 QP1, QP2 和 MR1, PD2 关联 QP3, QP4 和 MR2. QP1 和 QP2 可以在权限与地址范围允许的情况下使用 MR1, 不能直接拿 PD2 的 MR2 来作为自己的本地工作 buffer. 一个 PD 可以关联多个 QP 和多个 MR, 一个 QP 也可以使用同一 PD 下的多个 MR.
ibv_pd 中的 context 和 handle 可以这样理解:
context: 指向打开的 RDMA 设备上下文, 表明这个 PD 关联哪个设备上下文.handle: 用户态结构中标识底层 PD 资源的句柄, 不是 buffer 地址, 也不是应用直接操作网卡的指针.
用户态的 ibv_pd 是资源的表示, 实际保护状态由驱动和网卡配合维护. PD 也不负责分配应用 buffer. PD 接口, rdma-core 数据结构.
MR 描述已经注册的内存
MR (Memory Region) 是一段已注册内存的描述, 包括地址范围, 访问权限, lkey 和 rkey. 应用通常先分配 buffer, 再调用 ibv_reg_mr(pd, addr, length, access) 注册.
本地 WR 通过 SGE (Scatter/Gather Element) 指定 addr, length 和 lkey. 对端执行普通 RDMA READ/WRITE 时, 则需要目标地址 remote_addr 和相应的 rkey, 并满足 MR 的远程访问权限. MR 接口.
CQ 的创建参数使用设备 context, 不使用 PD. QP 创建时指定 send_cq 和 recv_cq, 两者可以是同一个 CQ; 多个 QP 也可以共享 CQ. 因而不能把 CQ 简单画成 PD 下面的一种资源. CQ 接口.
CQ 和 CQE 如何记录完成结果
CQ (Completion Queue) 是完成队列, CQE (Completion Queue Entry) 是其中的一条完成记录. 可以把它看成生产者和消费者模型:
- 网卡生产 CQE, 写入完成队列.
- 应用调用
ibv_poll_cq()取出完成结果, 消费相应 CQE.
ibv_poll_cq() 返回标准的 ibv_wc (Work Completion) 结构. 常用字段包括 wr_id, status, opcode, byte_len 和 qp_num. 先检查 status, 再解释成功完成对应的字段; 失败时并非所有字段都有意义.
poll CQ 读取的是完成结果, 实际 payload 仍在 MR 对应的 buffer 中. 应用可以用提交 WR 时设置的 wr_id 找回 buffer 或请求对象. poll 会消费 CQE, 所以多个消费者不能各自假定能读到同一条结果. 完成队列轮询接口.
发送侧是否为每个成功 WR 产生 CQE, 取决于 sq_sig_all 和 IBV_SEND_SIGNALED 等设置. 提交一个 WR, 不能直接等同于一定收到一个成功 CQE. 发送接口.
接收侧的完整过程
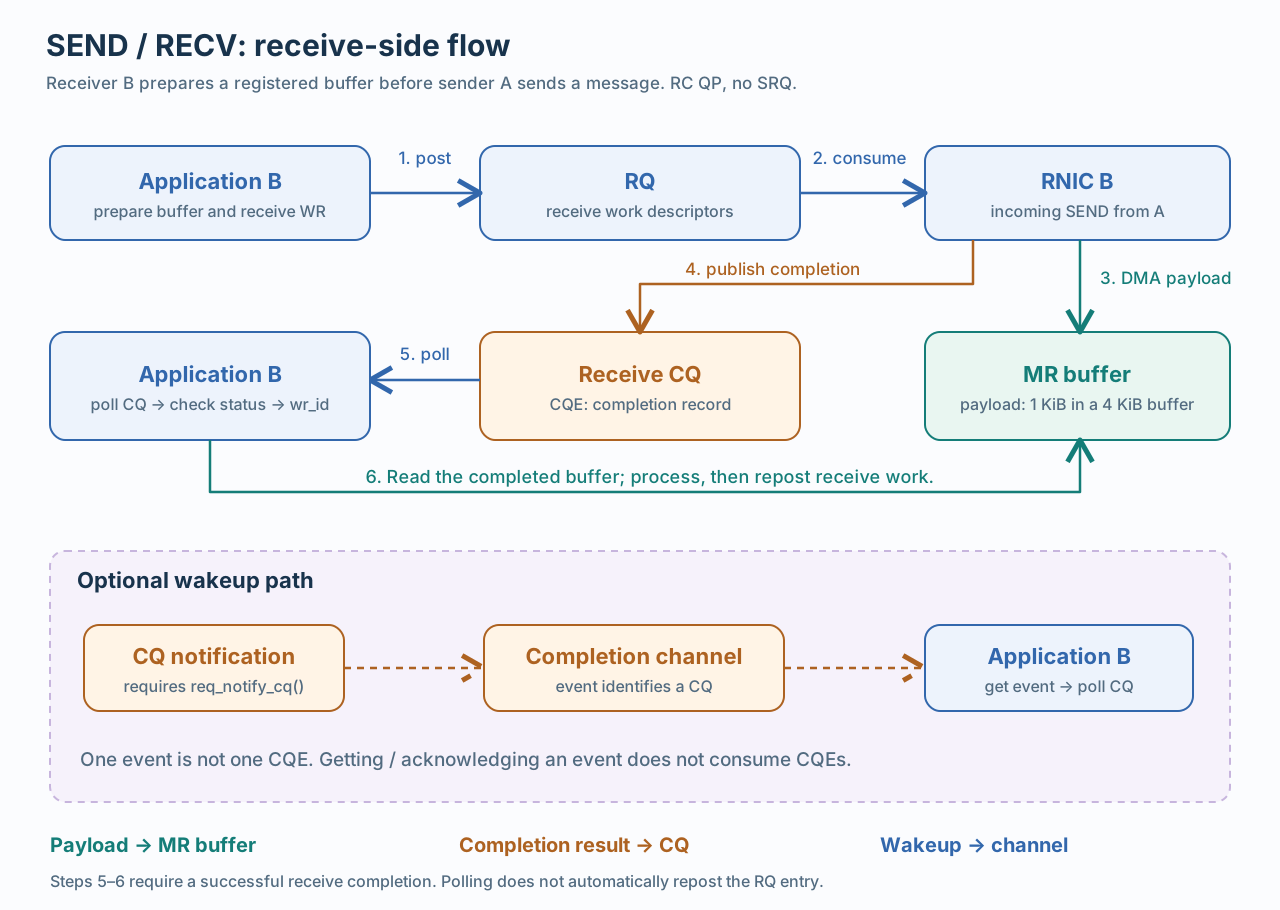
接收侧的执行顺序可以展开成以下步骤:
- 应用提交接收 WR. 例如准备一个 4 KiB buffer, 注册 MR, 再构造
wr_id = 7的接收 WR, SGE 指向这块 buffer.ibv_post_recv()将请求提交到 RQ. - 网卡消费接收 WQE. A 的 SEND 消息到达 B 后, B 的网卡取出已提交的接收描述符.
- 网卡写入数据. 如果收到的是 1 KiB 消息, 网卡将这 1 KiB 数据 DMA 写入对应 buffer.
- 网卡产生 CQE. 数据接收完成后, 网卡向关联的接收 CQ 写入完成记录.
- 应用获取完成结果. 应用 poll CQ, 检查成功状态, 通过
wr_id = 7找到 buffer, 根据有效的byte_len处理这 1 KiB 数据. - 应用补充接收请求. buffer 处理完毕后, 可以重新提交接收 WR. poll CQ 不会自动把已消费的接收 WQE 补回 RQ.
如果采用事件通知, 第 4 步之后还可以通过 completion channel 唤醒应用, 然后应用继续执行第 5 步. 应用也可以直接轮询 CQ, 不使用 channel. 接收 WR 与 buffer 复用.
Completion channel 通知应用来检查 CQ
一直 poll CQ 会占用 CPU. Completion channel 提供事件通知机制, 应用可以等待通知, 被唤醒后再检查 CQ.
创建 CQ 时可以关联一个 channel, 一个 channel 可以服务多个 CQ. ibv_get_cq_event() 返回时, 会告诉应用这次事件对应哪个 CQ. 这里需要区分四个接口:
| 接口 | 作用 |
|---|---|
ibv_req_notify_cq(cq, 0) |
为 CQ 开启下一次完成通知, 本身不等待 |
ibv_get_cq_event(channel, ...) |
等待并取出一个通知事件, 返回对应 CQ |
ibv_ack_cq_events(cq, n) |
确认已经取出的 n 个通知事件 |
ibv_poll_cq(cq, ...) |
取出实际完成结果, 消费 CQE |
通知是 one-shot 的, 触发后需要重新 arm. 一次 event 和 CQE 数量不是一一对应关系: 应用被唤醒时, CQ 中可能已经积累多条 CQE; 某些时序下, event 到来后 CQ 也可能已经被 poll 空. ack event 不会消费 CQE, get event 也不会读取 payload. Channel 接口, 通知请求.
一个常见顺序是:
1 | 准备阶段: |
这里先重新 arm, 再把 CQ poll 空. 如果反过来, 在最后一次 poll 返回空之后, 重新 arm 之前, 恰好出现一个 CQE, 应用可能错过这条完成的通知并进入等待. ack 可以批量进行, 但每个成功取出的 event 最终都需要被确认. 官方事件处理示例.
SEND 和普通 RDMA WRITE 的区别
上面的 RQ → buffer → CQ 流程描述的是 SEND/RECV. 对于 RC QP, 几种操作的接收端行为不同:
| 操作 | 接收端是否需要预先 post receive | 数据写到哪里 | 接收端完成通知 |
|---|---|---|---|
| SEND/RECV | 需要, 消费接收 WQE | 接收 WQE 指定的 buffer | 产生接收完成 |
| 普通 RDMA WRITE | 不需要为这次写入准备接收 WQE | remote_addr 和 rkey 指定的目标内存 |
不自动产生接收 CQE |
| RDMA WRITE WITH IMM | 需要, 消费接收 WQE | 仍写入远程地址指定的内存 | 产生携带 immediate data 的接收完成 |
因此, 普通 RDMA WRITE 的目标应用要如何得知新数据已经可用, 需要额外约定通知或同步机制. 发送端看到本地完成, 也不能据此推断远程应用已经处理了数据. 发送操作类型.
RoCEv2 的 ECN 和 CNP 反馈
再看一个链路速率不同的例子. A 通过 100 Gbps 链路连到交换机, 交换机再通过 25 Gbps 链路连到 B. 两段链路各自有自己的速率. 如果 A 持续以 100 Gbps 向 B 发数据, 交换机朝向 B 的出口只能以 25 Gbps 排出, 数据就会在该出口队列积累.
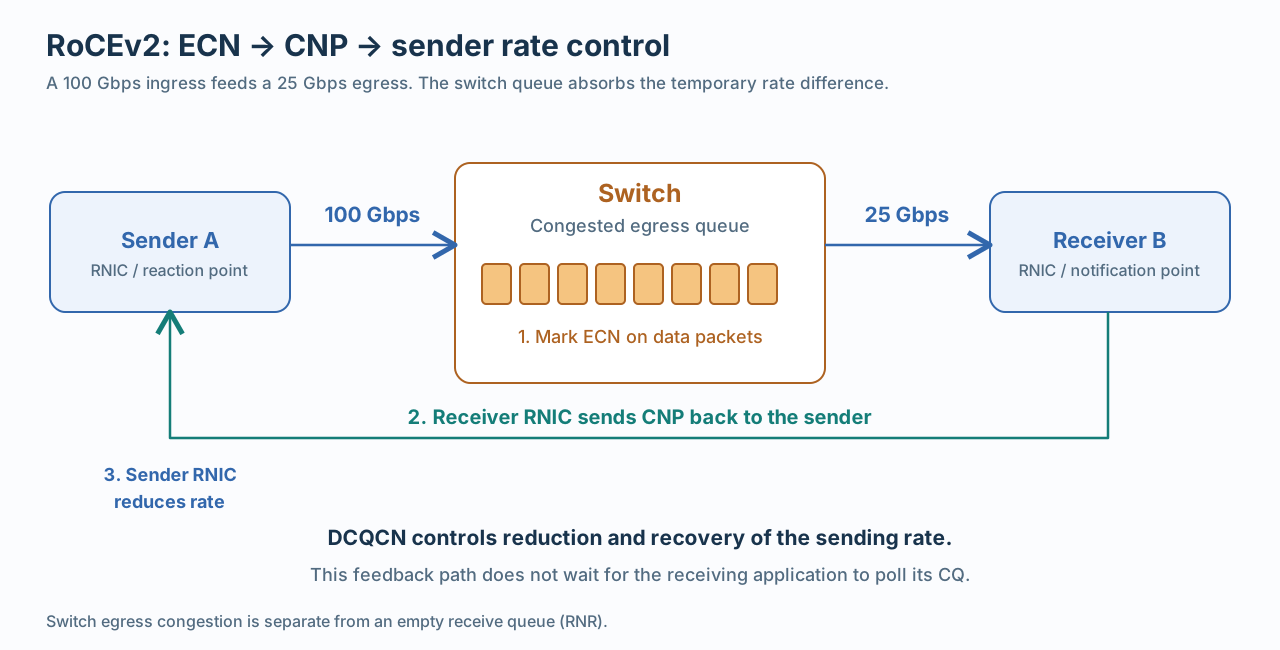
在忽略协议开销和其他流量的简化计算中, 队列增长速率为 100 - 25 = 75 Gbps, 即约 9.375 GB/s. 若这个速率差维持 100 us, 就会额外积累约 0.94 MB 数据. 缓冲只能暂时吸收速率差.
RoCEv2 配合 DCQCN 时, 反馈链路可以记成:
- 交换机根据拥塞队列状态, 对经过的数据包进行 ECN 标记.
- B 的网卡收到被标记的数据包, 按通知规则向 A 发送 CNP (Congestion Notification Packet).
- A 的网卡收到 CNP, 由 DCQCN 降低相关流的发送速率, 后续再按算法恢复.
所以这条路径是 交换机标记 ECN → 接收端网卡回 CNP → 发送端网卡调速. 它不需要 B 的应用先 poll CQ 再通知 A. 应用提交到 SQ 的速度和网卡真正在线路上发送数据的速度也可以不同. NVIDIA DCQCN 机制说明.
交换机出口排队和接收端 RQ 耗尽要分开理解. 前者是网络的输入速率超过出口服务能力, 后者是 SEND 到达时没有可用的接收 WQE, 在 RC 中可能引起 RNR (Receiver Not Ready) 及重试. PFC 则是另一种逐跳, 按优先级的暂停机制, 与 ECN/CNP 的端到端反馈不同. 大规模 RDMA 部署经验, 第 7 节.