1. MoE 架构
Challenge
- GPU 并不像 CPU 那么适合做 branching 操作,如果我们在 kernel 中写一个 if-else 指令,那么两个 branch 的函数执行都会被放到解释器这里来,导致执行速度慢于完全并行同等操作;
- 如果让 batch inference 请求同时通过这个 moe-FFN 层, 这个 batch 内必须统一 expert 而不能分开;
主要框架
标准公式
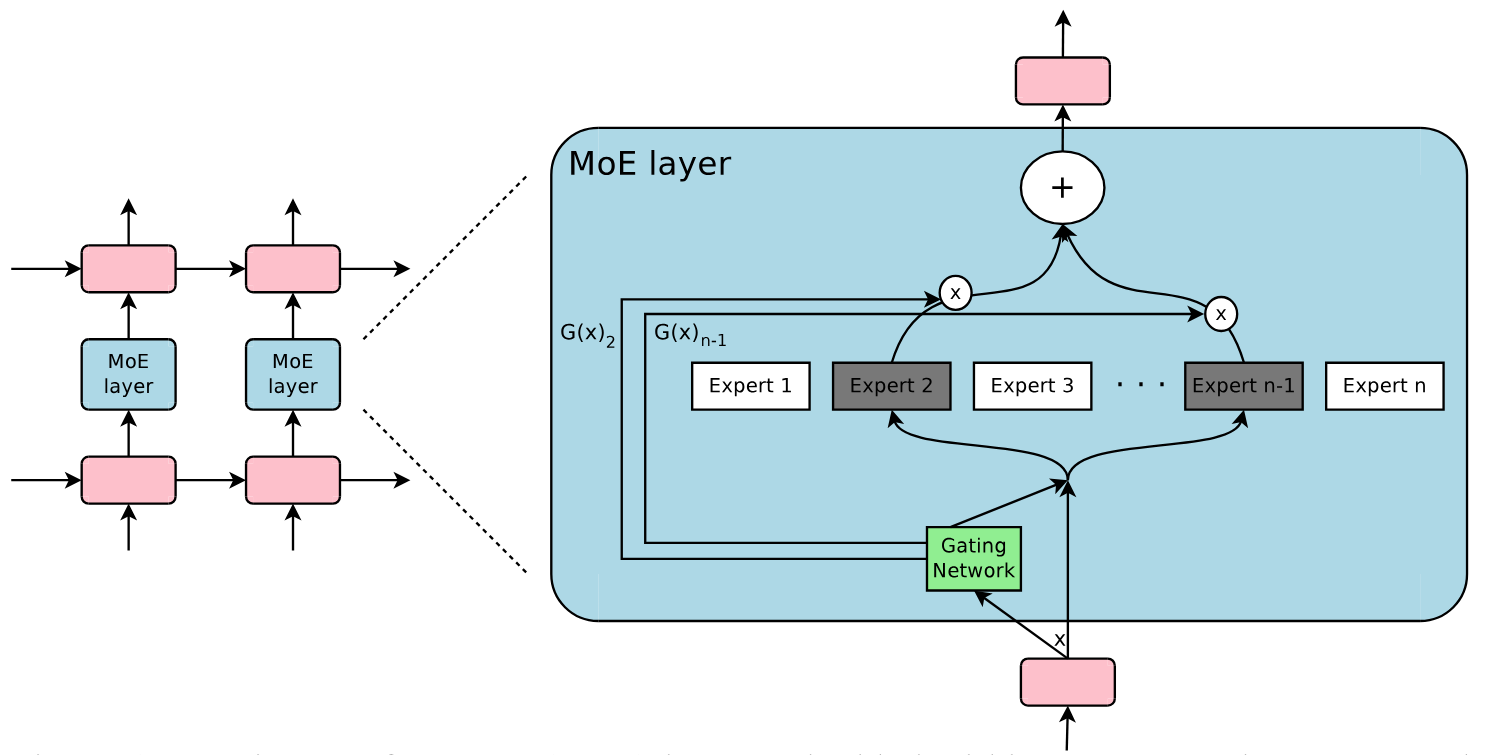
这里的 指的是 gating, 用于将输入的 x 向量映射到 n 个 experts 对应的输出用于表示权重; 这里 G 就是一个可训练的神经网络, 可以写作
但是我们用 moe 其实是希望减少计算量,所以需要让很多 expert 模块完全不运行, 这里就需要用类似 top-p 的算法来只要 cumulative 前 占比的 expert 运行;
在原论文中还提出了用 noise 方法来实现 load-balancing 的效果,这里主要是避免 gater 训练的时候把任务分给了几个主要的 expert 而让剩下的几个效果很差;
性能分析
Shrinking Batch Size Problem
对于大模型 serving 的时候需要有大 batch size 并发运算才能提高整体程序的运行效率,但是 moe 的存在会把 attention batch 内不同的 request 映射到不同的 experts 那里,每个 request 跑的 expert 数量肯定比总 expert 数量小,导致每个 expert 手上遇到的 请求数量会比总 batch 尺寸小,一般会小很多;因此其实对于 expert 内部有浪费一定的算力
这里作者提出了三种可行的扩大 batch size 的方法:
- 每张显卡放固定数量的 experts, 也就是新增 expert 不影响已经训练、放置好的 expert 的数据
- 这里问题是新增 expert 会导致我们的 router 模型需要重新训练
- 注意这里的 router 和 expert 一般是端到端一次同时训练好的,不能说我们固定了 expert 的权重之后专门训练 router
后面两个方法由于当时时代限制 (当时不是 attention 而是用 LSTM, 并行度支持不如现在的 attention 模块的 矩阵乘法)
Switch Transformers
这篇论文在前作的 Top-k 选择 expert 的基础上极端化用 Top-1 只选择最高分的那个输出,从生成质量上看效果也不错,
参考文献
[1] OUTRAGEOUSLY LARGE NEURAL NETWORKS: THE SPARSELY-GATED MIXTURE-OF-EXPERTS LAYER
[2] GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding