3. Speculative Decoding
Speculative Decoding 的朴素思想
想要加速一个 auto-regressive 模型的推理, 可以先猜测合理的上下文, 再让大模型一次验证多个位置; 比如已经有 prefix, 小模型先猜出 I love cats, 大模型验证后保留 I love, 在 cats 这里拒绝并补出 dogs, 后面基于 cats 生成的内容就不能继续保留;
这里有两个角色: Draft Model 负责快速生成候选, Target Model 负责验证和确定最终输出; 上面的例子是在说明接受前缀和截断的位置, 随机 sampling 下的接受规则还需要下面的概率推导;
本文主要根据四页手稿整理, 保留从 sampling 理论到 SpecInfer, Medusa, EAGLE-1 的顺序; 图片选用原论文架构图, 对手稿中公式或表述的必要修正单独说明;
理论部分对应 Google 的 Fast Inference from Transformers via Speculative Decoding 和 DeepMind 的 Accelerating Large Language Model Decoding with Speculative Sampling; 两篇独立提出了相近的机制; 本文统一用 表示 target, 表示 draft, DeepMind 原文的字母约定与这里相反;
从 LM head 到 sampling distribution
先把模型输出和 sampling 分开看; 输入 tokens 经过 Transformer blocks, 得到当前位置的 hidden state , 然后 LM head 将它映射到 vocabulary 上的 logits;
Logits 还不是概率向量; temperature, softmax, top-k / top-p 等操作共同决定实际 sampling distribution; greedy decoding 也可以理解成把概率质量全部放在 argmax token 上;
因此手稿里的 和 是两组 logits, 真正进入接受公式的是经过各自 sampling policy 后的 和 ; 其中 必须是实际生成候选的 proposal distribution, 是最终希望保持的 target distribution; 两者不要求使用相同的 policy, 但不能在 sampling 时用一套分布, 在接受比里又代入另一套;
给定同一个 prefix, 暂时省略条件, 记为:
这里 是 draft 抽中的候选, 表示候选被接受, 是经过接受或 correction 后最终输出的 token;
Acceptance 与 correction
一次 sampling 怎么执行
手稿中的两次随机采样对应两件不同的事:
- Draft 给出 , 抽取候选 ; 可以用第一个均匀随机数 在 的累积概率区间里选择 token;
- Target 给出同一个 prefix 下的 ;
- 对已经选中的候选 , 计算 ;
- 再独立抽取 ; 若 , 接受并输出 ;
- 若拒绝, 从归一化后的 中重新采一个 token, 作为最终输出;
其中 ; 接受概率是:
直观上, 当 时, draft 在这个 token 上没有放入过多概率质量, 抽到它就可以接受; 当 时, draft 放得过多, 需要按 的比例保留;
这里的 是给定候选已经抽中后的条件接受概率; 它不是 target 独立 sampling 后恰好也抽中 的概率, 也不是通过 Bayes 公式从 推出一个后验 ;
为什么接受概率恰好是这个比值
手稿的思路是: 先要求最终输出严格服从 , 再在这个约束下尽可能多接受 draft;
对于一个 token , 由 draft 抽中并被接受的联合概率为:
最终输出 有两条路: 直接接受 , 或者拒绝后通过 correction 输出 ; correction 只能补上非负的概率质量, 所以必须满足:
再用全概率公式计算整体接受率:
于是得到手稿里的优化问题:
对每个 的位置分别取到上界, 就得到:
需要修正手稿里的一句话: 并不是所有位置都能取到 ; 只有 时可以取等号; 当 时, 最多只能把 draft 提供的 全部接受, 剩下的质量由 correction 补齐;
这个最优性限定在当前问题里: 给定一次 , 接受时直接输出 , 拒绝后允许 correction; 它不等于所有多候选或整块验证算法的全局最优性;
Correction 为什么用正残差
已经通过 acceptance 分配给 token 的概率质量是 ; 为了凑成 , 还缺少:
记整体接受率为 , 拒绝率为 :
拒绝发生时, 从下面的 residual distribution 采样:
这样最终分布就是:
这就是手稿最后写出的 acceptance + correction = target distribution; 其中 是未归一化的接受质量, 总和为 , 不能直接当成总和为 1 的新概率分布; 同样, 是拒绝条件下的分布, 回到最终输出时必须乘上拒绝率 ;
如果 , 则 , 所有候选都接受, 不会进入 correction; 如果 , draft 不会抽到这个 token, 不需要计算该处的 , 但 correction 仍可以给它分配质量;
以上与 Google 论文的 Algorithm 1 和 Appendix A.1 对应; 手稿这里通过带约束的优化问题, 也解释了为什么选这个 acceptance rule;
手稿中的数值例子
取手稿第二个例子:
| Token | Target | Draft | 条件接受概率 | 接受质量 | 待补质量 |
|---|---|---|---|---|---|
| A | 0.2 | 0.5 | 0.4 | 0.2 | 0 |
| B | 0.3 | 0.2 | 1 | 0.2 | 0.1 |
| C | 0.4 | 0.2 | 1 | 0.2 | 0.2 |
| D | 0.1 | 0.1 | 1 | 0.1 | 0 |
整体接受率是 , 拒绝率是 , 所以:
例如 draft 抽到了 A, 若第二个随机数为 , 就接受 A; 若为 , 就拒绝 A, 再按 从 B 或 C 中采样; 最终接受路径贡献 , 拒绝路径贡献 , 相加恰好等于 ;
手稿另一个例子是 , ; 此时 , 但相乘得到的是 , 还要补上 才得到 ;
从单个 token 接到一段 draft
小模型先自回归生成 个候选, 大模型再对这些已经给定的候选位置做一次并行 forward; 每个位置仍然使用自己对应的 prefix, 并没有取消模型的因果依赖;
随后按位置顺序判断接受情况; 在第一个拒绝的位置 , 从 采样 correction, 并丢弃这条 draft 后面的候选; 如果全部接受, 还可以从已经算出的 再采一个 bonus token;
因此一轮推进的是 连续接受的 draft tokens + 1 个 correction / bonus token; 每轮至少推进一个 token, 但这只减少 target 的串行调用次数, 不保证总时间一定更短, 因为 drafting 和 verification 本身都有成本;
SpecInfer: 提高一次验证的有效长度
手稿里对 SpecInfer 的关注点是: 单条 draft 只覆盖一条未来路径, 如果前面的某个 token 没匹配上, 后面做的工作就浪费了; 那么可以让候选包含多个分支, 提高一次 target forward 能走下去的长度;
这里用 tree 表示多个可能的 continuation, 既能共享前缀, 也能让 target 一次计算多条路径对应的条件分布; 手稿将核心指标记为 matching length per unit time; 进一步区分实际输出长度与单纯的匹配长度, 可以写成:
分子要分清是 accepted draft length 还是包含 correction / bonus 的 output length; 分母也不能只看 target verification; 增加树的宽度, 未必能提高这个比值;
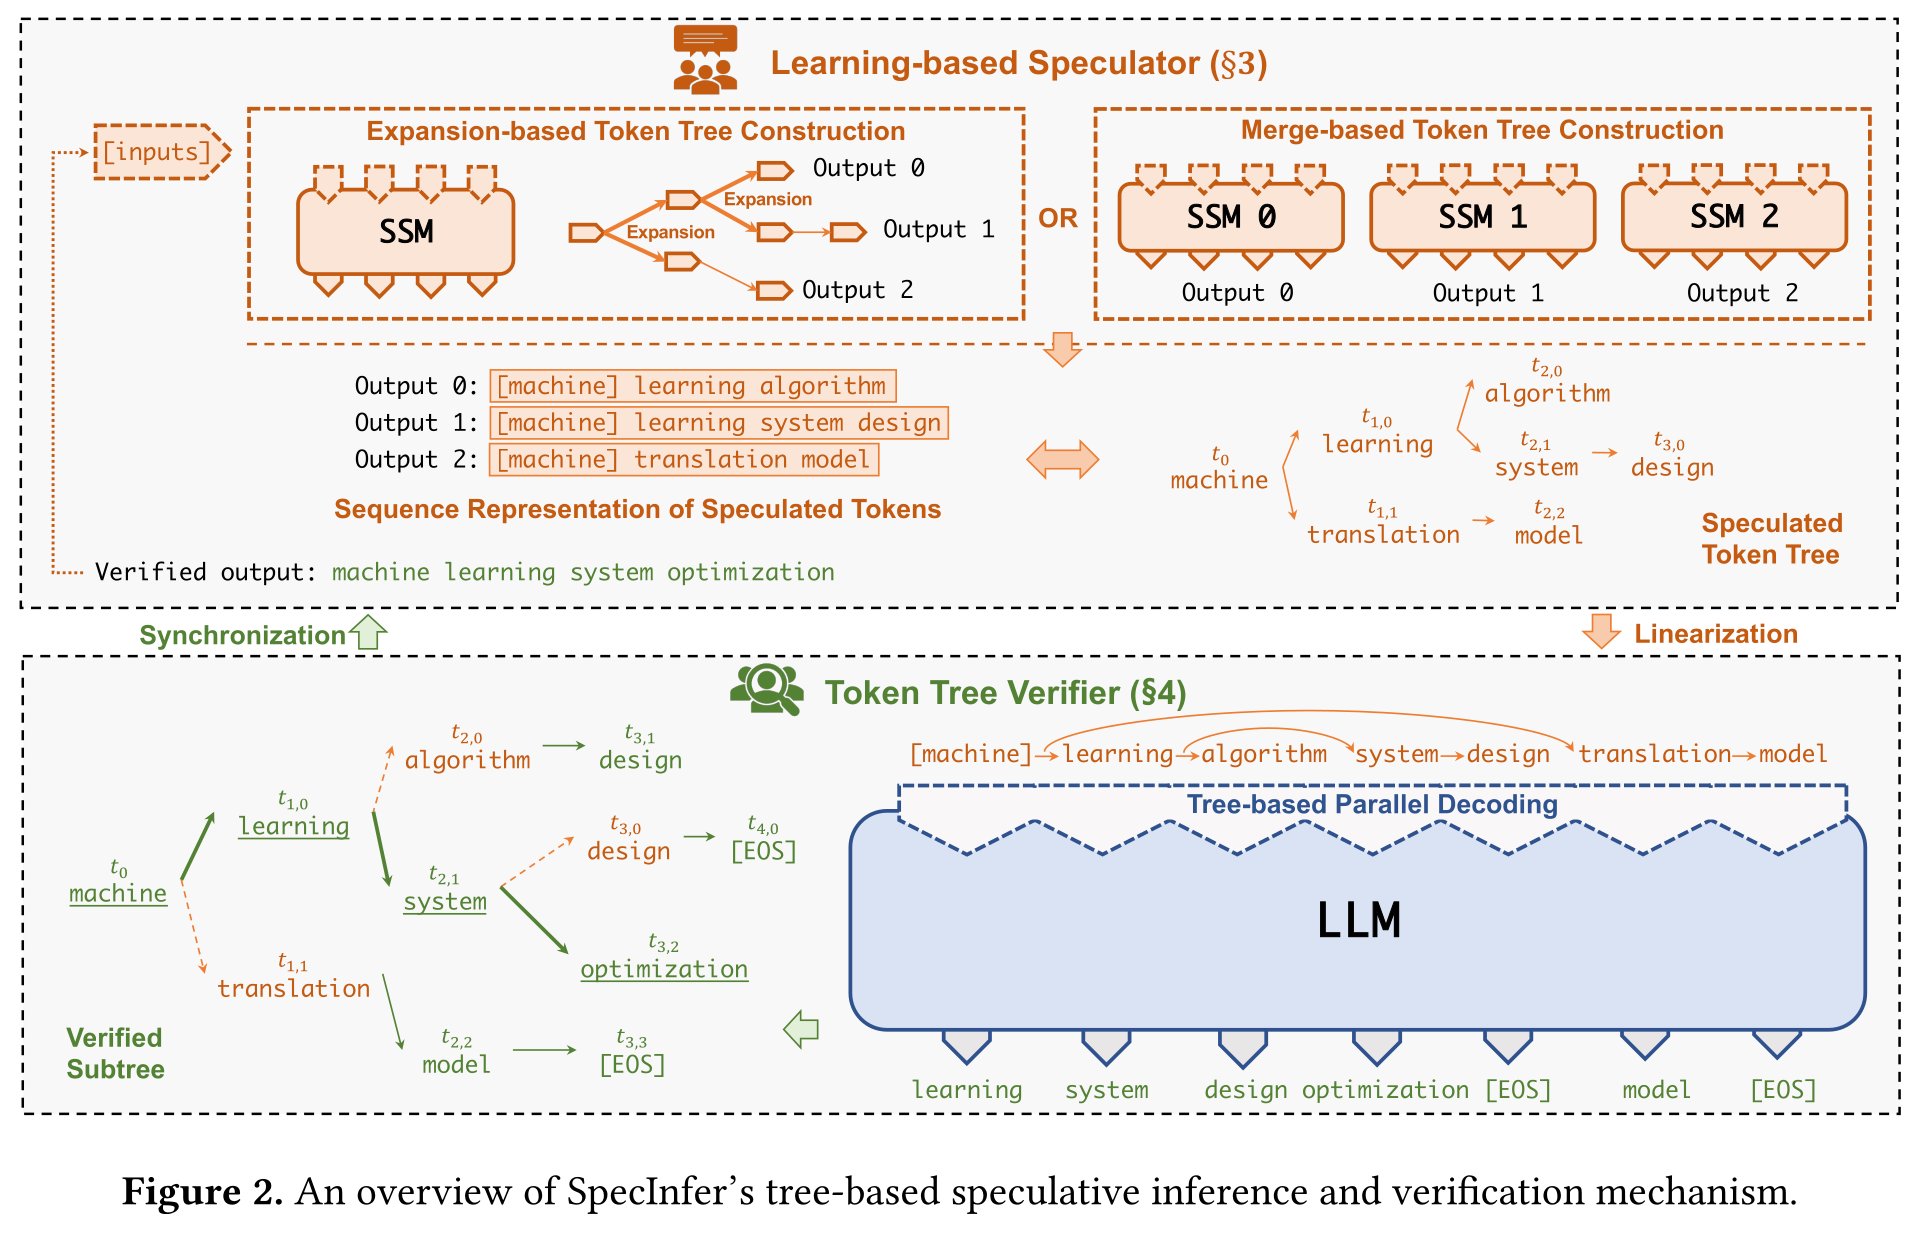
原论文 Figure 2: SpecInfer 的 tree-based speculation 与 verification, 上半部分组织小模型候选树, 下半部分由 target 并行验证; 对应手稿里的 Learning-based Speculator 和 Token Tree Verifier;
Learning-based Speculator: expansion 与 merge
手稿把困难分成两个: 有限成本下挑出值得猜的路径, 以及 如何验证一棵树; 前一个问题对应 Learning-based Speculator, 其中又有两种组织方式;
| 方式 | 手稿中的理解 | 具体操作 |
|---|---|---|
| Expansion | 一个 SSM 扩展多个候选 | 从同一个 small speculative model 的输出中构造多个 continuation |
| Merge | 多个 SSM 并行生成后合并 | 合并相同前缀, 保留分歧处的不同分支 |
如果每一层都保留 个孩子, 深度为 的树可能增长到 个节点; 因此手稿中写到的内存压力是合理的, 不能无限扩展;
SpecInfer 的 ASPLOS 版本使用 static expansion configuration 控制每层分支数; 手稿里的 可以作为自己的示例: 前两步每个节点只留一个孩子, 第三步留三个, 后面沿各分支继续单路延伸; 论文给出的示例是 ;
对于 merge, 手稿还记了 collective boost-tuning: 先用 target 生成训练序列, 训练第一个 SSM; 再把它已经覆盖的训练样本移除, 让后续 SSM 学剩下较难匹配的部分; 这样多个小模型更可能提供互补的候选, 而不是重复猜同一条路径;
多个 SSM 可以并行运行, 但是否隐藏额外成本取决于硬件与部署; 模型参数更少, 也不意味着单 token latency 按参数量同比下降;
Token Tree Verifier: topology-aware causal mask
手稿中 tree attention 的核心是 每个节点只看自己的祖先路径; 将整棵树展平后, 不能直接使用普通下三角 mask, 否则不同分支会看见不属于自己上下文的 tokens;
以公共 prefix I like 为例:
| 树中节点 | 父节点 | 该节点 attention 可以看到的 token context |
|---|---|---|
a: cats |
prefix | I like cats |
b: dogs |
prefix | I like dogs |
c: because |
a | I like cats because |
d: and |
a | I like cats and |
e: because |
b | I like dogs because |
这里 c 和 e 虽然是同一个 token, 但祖先不同, 所以是两个节点; mask 允许公共 prefix, 当前节点的祖先与自身, 屏蔽其他分支; position 也按路径深度对齐; 节点的 hidden state 给出其后一个 token 的分布, 验证某个孩子时读取对应父上下文的预测;
整个过程是 target 先对候选树做一次并行 forward, 再根据结果选择可提交的路径; 并不是某条路径失败以后, 才重新跑 target 检查另一条; 最终只保留实际接受路径上的 tokens 与有效 KV, 其他分支不进入真实上下文;
随机 sampling 下, tree attention 只负责高效得到条件分布, 还需要正确的 acceptance / correction; SpecInfer 的 multi-step speculative sampling 在拒绝一个候选后, 更新当前 residual distribution, 再检查后续候选, 不能让每个兄弟节点都独立对原始 重试; 接受比里的 也必须对应实际 proposal 过程, 不能随意给一个确定性 top-k 节点套原始 softmax 的 ; 对应 论文 Algorithm 2;
并行验证的 memory I/O 直觉
手稿的直觉是: decoding 经常受 memory I/O 限制, target 同时验证少量 tokens 时可以复用读取的 weight tiles, 提高 arithmetic intensity; 多验证几个位置的 latency 可能小于逐个位置单独调用 target 的总和;
这里需要把手稿的 “并发验证不存在计算卡顿” 收窄: 小树可能利用原先闲置的算力, 但 verification 不是免费的; 树越大, activation, KV, attention 与矩阵计算的成本越高; 原论文也观察到较大 batch 下扩树会增加 verification latency, 所以仍要看每单位时间推进多少 tokens;
手稿中的 4:1, 3~7:1 和旁边的速度数字没有清晰注明单位与配置, 这里不把它们写成通用结论; 能在 旧版作者 PDF 核对到的是特定实验中 SSM 的 per-token latency 改善约 ; 旧稿还讨论了 learned scheduler 与 matching length per unit time, 但 ASPLOS 版本采用静态扩树配置, 两个版本应分开;
Medusa: 从同一 hidden state 预测多个未来位置
手稿在 Medusa 这里重新画了 LM head: tokens 经过 Transformer 得到 , 原始 LM head 预测 ; Medusa 在同一份 上增加多个轻量 heads, 分别预测更后面的 tokens;
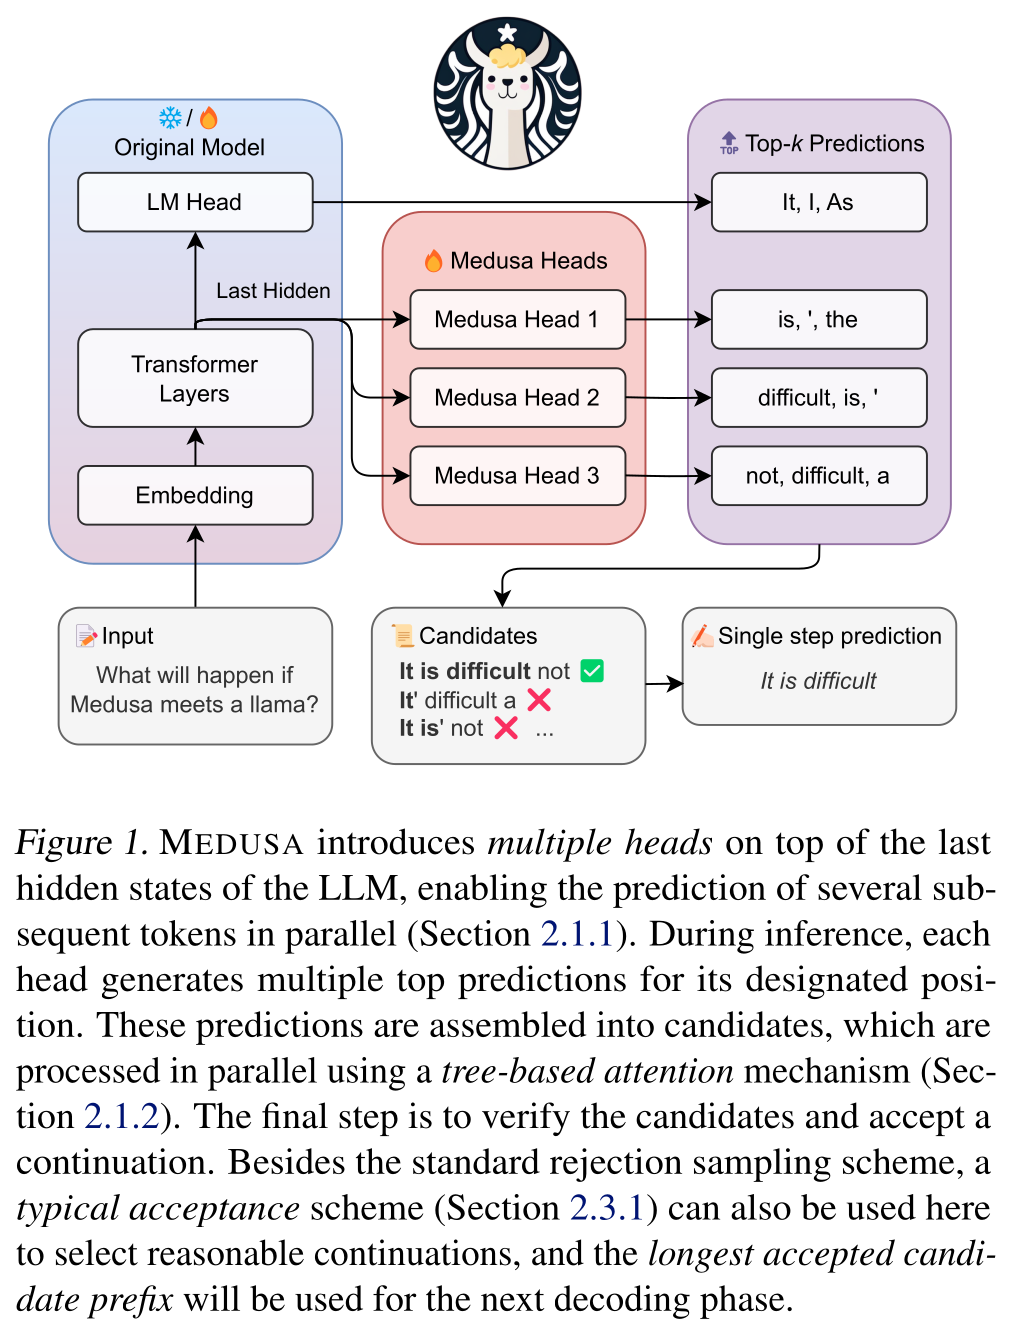
原论文 Figure 1: Medusa 从 base model 的 hidden state 接出多个 decoding heads, 将候选组织成树后交给 base model 验证; 对应手稿中 hidden state, 多组 logits 和 tree 的连接关系;
多个 heads 预测什么
| Head | 输入 | 预测位置 |
|---|---|---|
| 原始 LM head | ||
| Medusa head 1 | ||
| Medusa head 2 | ||
| Medusa head |
每个 Medusa head 包含带 residual connection 的轻量变换, 再投影到 vocabulary; 用列向量约定可以写成:
重点是 多个 heads 同时读同一个 , 后面的 head 不会等待前一个 head 采样出的 token; 所以它们可以并行预测多个未来位置, 但某个 head 的输出不等于已经条件化在选定前面候选上的精确 next-token distribution;
从各位置候选拼成 tree
手稿里的 是不同 heads 的 logits; 从每个 head 取多个候选, 就可以将这些未来位置的组合组织成树; 比如第一个 Medusa head 保留 2 个 token, 第二个保留 3 个, 简单笛卡尔组合就得到 6 条 continuation;
实际可以预先选择部分组合, 控制树的大小, 不必展开全部组合; 验证时使用 topology-aware causal mask, 共享 prefix 的计算与 KV, 每条路径仍然只看自己的上下文; 这部分可以与前面 SpecInfer 的 tree attention 放在一起理解;
Medusa-1 与 typical acceptance
手稿记到 Medusa-1 冻结 base model, 只训练额外的 Medusa heads; Medusa-2 则联合训练 heads 与 backbone; 这是 训练时是否修改 target 参数 的区别, 不能据此判断 decoding 时是否保持原 sampling distribution;
手稿中 typical acceptance 的关键词是 probability threshold; 对某条候选路径上的 token, 论文使用:
其中 是 entropy, 是固定阈值, 调节 entropy-dependent threshold; target 分布越分散, 可接受的概率阈值可能越低; 按规则选出最长的可接受前缀, 论文这套策略对第一个 token 使用 greedy 并直接接受;
Typical acceptance 不具有前面 加 residual correction 的严格分布保持保证; 它在可接受的生成质量与加速之间做取舍; 因此需要区分 “base model 参数被冻结”, “greedy 输出是否一致”, “随机 sampling distribution 是否保持” 这三件事; 对应 Medusa Section 2.3.1;
另外, 两次独立 sampling 恰好抽到不同 token, 不代表标准 speculative sampling 必然拒绝; 对前面推导的接受规则, 当 时接受率就是 1;
EAGLE-1: Feature-level autoregression 与 shifted token
手稿到 EAGLE-1 的问题是: 能不能让一个很小的 drafter 复用 target 已经算好的 feature, 然后在 feature level 自回归地预测后续位置;
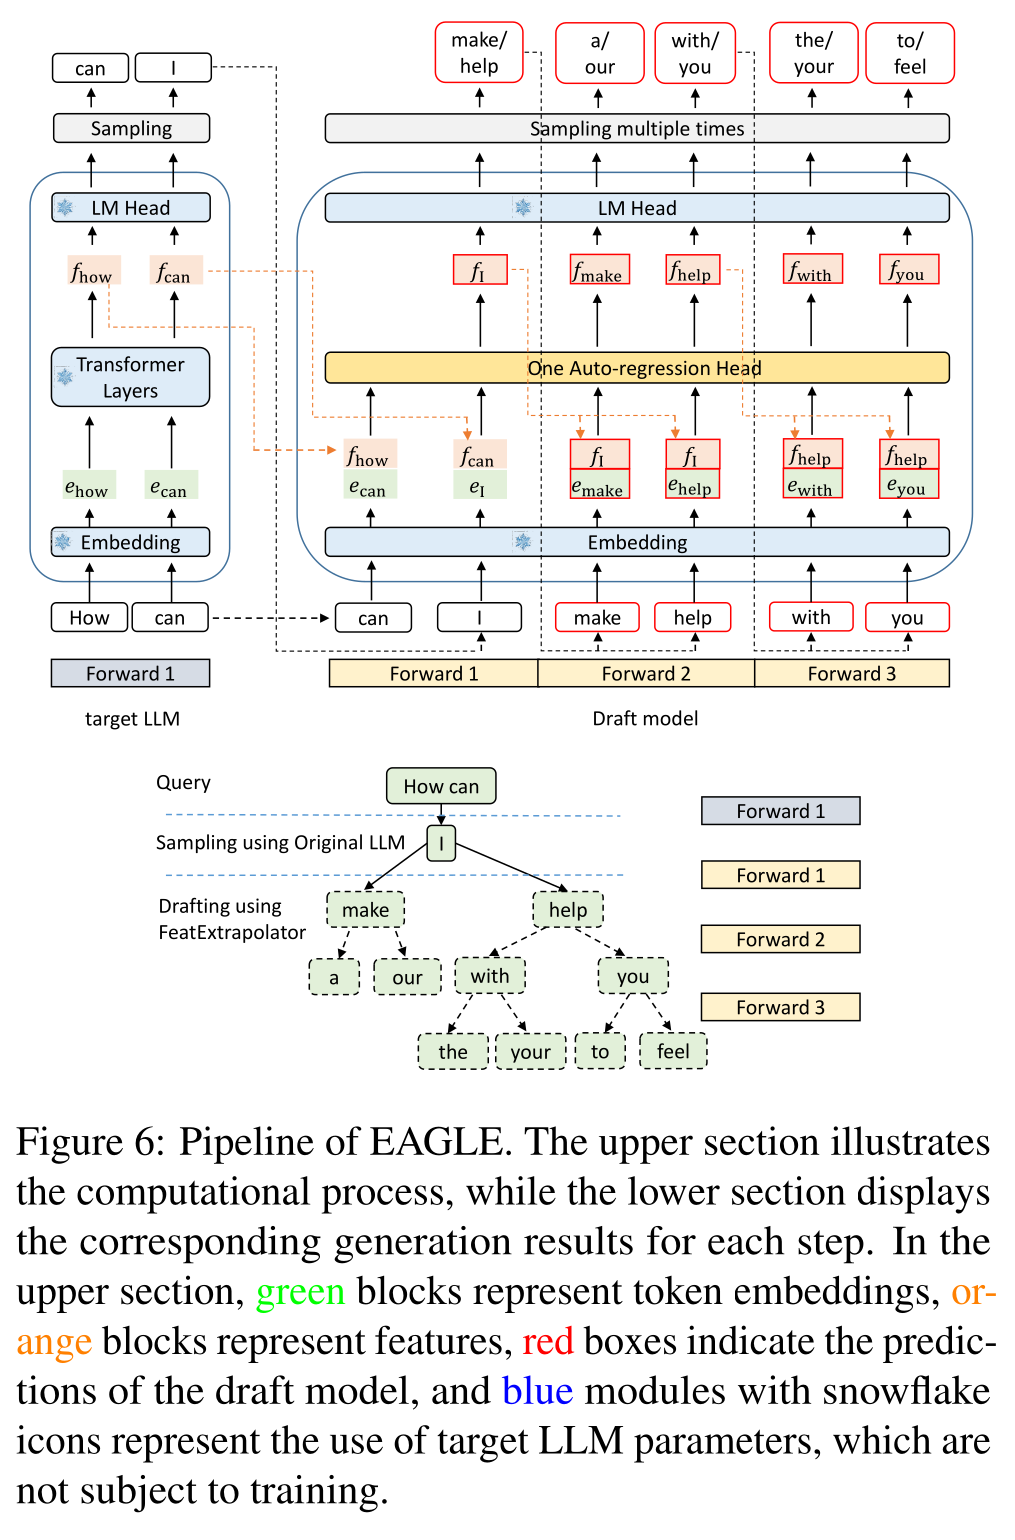
原论文 Figure 6: EAGLE-1 的 drafting pipeline, feature 与提前一位的 token embedding 拼接后输入 Autoregression Head, 预测的 feature 再经原始 LM head 生成后续候选; 下半部分对应多轮扩展得到的候选树;
为什么只给 feature 还不够
沿用手稿的 How can 例子; target 处理完 How can 后得到 feature ; 它可以给出下一个 token 的分布, 但下一个 token 可能抽到 I, 也可能抽到其他词; 一旦选择不同 token, 后续真实 feature 也会不同;
因此只给 , 就要求 drafter 直接预测下一位置的 feature, 会遇到 sampling 带来的分支不确定性; EAGLE 将已经选定的下一 token 也告诉 drafter, 例如现在明确选择了 I, 再预测 How can I 对应的 feature;
这里 是 token ID, 是 embedding lookup; feature 则带有 prefix 的上下文信息; 原论文将 feature 描述为 second-to-top-layer output, 指 LM head 之前的 hidden representation, 不能直接理解成倒数第二个 Transformer block;
Shifted 指的是位置错开一位
假设当前已有 , , target 已计算 , 并由原始 LM head 选出 ;
| 输入序列中的位置 | Feature | 与它拼接的 token embedding |
|---|---|---|
| 1 | , 对应 How |
, 即 can |
| 2 | , 对应 How can |
, 即已选出的 I |
然后进行:
如果 , 下一轮再追加 , 预测 , 然后生成 ; 第一轮使用 target 的真实 features, 后续会用到 draft 自己预测的 features, 因此仍有多步误差积累;
手稿中方框的下标需要修正为:
这个简式省略了 LM head 输出 logits, 再由 sampling policy 得到 的转换; 这里还要结合之前各位置的输入和 draft 自己的 attention history; 方括号里的分号表示 concatenation, 不是两个向量做乘法, 也不是简单相加;
小 drafter 如何生成候选树
拼接后的维度为 , 先由 FC 投影回 , 再由一个轻量 Transformer decoder layer 预测下一 feature; embedding 与 LM head 复用 target 参数; drafter 有自己的 attention 与 KV cache, target feature 是它的输入, 不等于直接复用 target 内部的 attention KV;
这也对应手稿中 Medusa 与 EAGLE 的区别: Medusa 的多个 heads 从同一份 feature 并行猜不同未来位置; EAGLE 则将 已经选定的 token 与 feature 对齐后继续自回归, 下一步候选会受到前面所选分支的影响;
EAGLE-1 使用预先设定的树形模板组织候选, 再让 target 通过 tree attention 一次验证, 配合 speculative sampling 的接受与 correction 保持 target 分布; 因上下文而动态分配树预算的设计属于后续 EAGLE-2, 不应混入这里的 EAGLE-1 架构;
将手稿里的三个架构放在一起
| 方法 | 候选从哪里来 | 手稿关注的核心机制 | 验证时要区分什么 |
|---|---|---|---|
| 经典 speculative decoding | 独立小模型自回归生成单条 draft | 接受概率与 residual correction | 保留连续接受前缀, 拒绝处补采样 |
| SpecInfer | 一个或多个 SSM 扩展, 合并候选 | 有限树预算, prefix sharing, tree attention | 并行算 target 与分布正确的路径选择是两个步骤 |
| Medusa | 同一 hidden state 上的多个未来位置 heads | 并行预测多个位置, 组合候选树 | Typical acceptance 与 exact sampling 的保证不同 |
| EAGLE-1 | Feature 与 shifted-token 驱动的小 drafter | Feature-level autoregression, 显式告知已选分支 | 固定候选树加 target verification, 保留严格 sampling 规则 |
这里的阅读顺序不代表严格的继承关系; 可以始终分两条线看: 候选怎样生成, 以及 target 怎样并行计算并决定最终输出;