2. FlashAttention
复杂度分析:从 FLOPS 到 HBM IOs
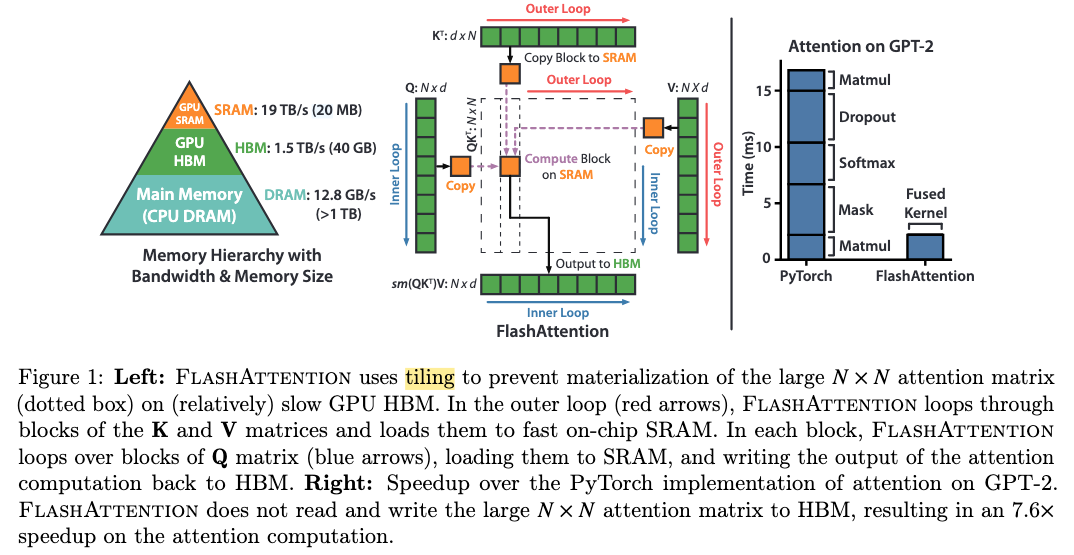
传统计算的优化,比如 gemm 的 cublas 实现分析都是专注于减少一个计算中 gpu flops 的数量,但是实际上 gpu 的高速内存 SRAM 和相对低速内存 HBM 的读写 IO 率也是影响整体程序性能的重要的因素;因此本文提出做一个 IO-aware attention kernel 来减少 IO 吞吐数量
Tiling
传统 gemm 中的 tiling 是指每次处理一个 block 而不是完整读写一整个行向量,这样可以提升 io 的连续性从而提升性能;但是这里的 attention 计算不能直接用 gemm 的优化,因为存在一个 需要全局 reduce 的 softmax 函数,并且需要用到全局最大值来做 max trick,这个其实是很不利于 tiling 这样分块的实现的
softmax 的背景是 , 对应的矩阵表示的是 query 与 key 之间的相似度/匹配度,然后权重的计算其实是对每一个 query 沿着不同的 key 去做的 reduce 合并,如果我们 key 没有全部参与计算的话,这里的 sub-Q 就会去匹配 sub-K sub-V,因此计算的 max 和 分母 denominator 也只是局部值;但是本文指出,可以通过缓存局部值来在 全局 reduce 的时候高效重建全局的 max 和 denominator 然后就可以得到正确的最终值了
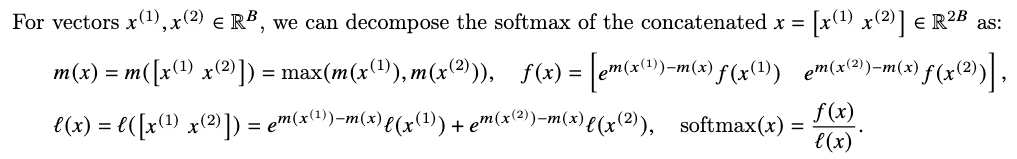
Attention Tiling
对于 Q 和 KV 分别分块为 , , 那么如何理解不同矩阵之间的关系从而还原到一个完整的矩阵呢
首先在 attention 公式下, QK 乘法得到的是 m 个 query 词和 n 个 kv 词之间的关系,由于我们最终输出的形状是 , 所以我们输出的其实是被 attention 理解过的 Q 查询向量,或者我们可以定义 KV 为 语境,attention 的结果就是返回 查询词在对应的 KV 语境下的含义;那么对于同一组查询词我们将 KV 分段,不同段相当于是不同语境,那么几个部分集合是需要 加权相加的,在数学公式上表示就是用已有的 l m 去还原完整矩阵;
如果对于一个给定的 KV 语境我们去更换不同的查询词 Q,那么结果就是这段语境对于特定查询词的影响,拼接不同的 Q 会得到当前语境对所有查询词的影响,但是仍然是中间状态,因为输出是要获得查询词对完整语境的理解
fa v1 算法是将 KV 给定去更换 Q,得到的就是中间值 Q-sub,不同的 KV 之间需要叠加输出 O
v1 算法实现
由于 softmax 的维度一定是沿着 KV 方向的,也就是用一个 query 去 attend 所有的 key,那么考虑到 K 和 V 的数据会比 Q 的相对大一点 (多一个矩阵),因此考虑把 KV 常驻在 SRAM 中,不断读写 Q 张量来计算 attention; 不过,从简单角度思考我们要尽快合并完整的 softmax 值,所以最好是直接沿着 KV 方向去合并,这样用类似 tiling 的本地合并占用尽量少的 sram 空间,并且还可以减少大量的 m 和 l 以及 O 的中间存储,这个是 fa-v2 论文的论点了,后文会提及;
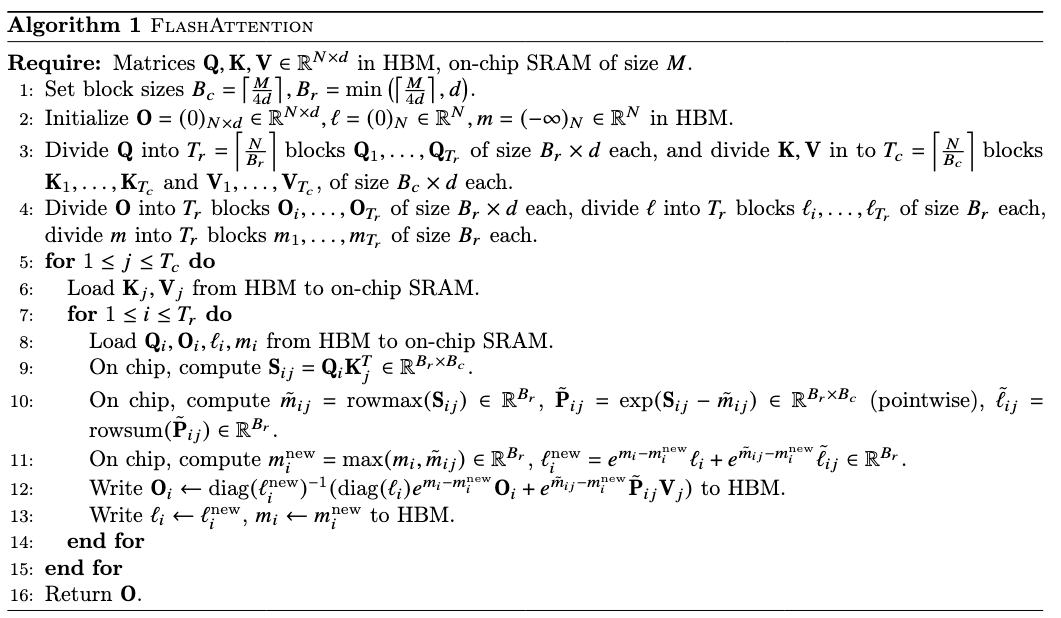
现在我们先来看这里的第一行:定义两个 block size:
- 表示的是 K V 用的 block 大小, 这里特指 sequence length
- 表示的是 Q 用的 block 大小
我们发现这里都用了一个 , 这里主要指的是中间存储数据 K V Q O 这四个矩阵,我们假设他们的大小相近都是 , 那么总的存储空间是 4Pd 必须不大于 M,也就是这里除法的来源
然后这里的 还有一个 min 作为上限,另一个 term 是 d,这是因为我们 sram 在计算中间值的时候需要临时缓存一个 , 这个矩阵的尺寸是上面所说的 这个数字可能会超过 M 的大小,所以需要一个 上界 来约束;这里的 d 带入原公式,中间矩阵的尺寸就是 , 也就意味着极限情况下 Q 张量用过就丢,剩下 KVO 占据上界 3M/4 那么剩下的就是 M/4 的空间