4. Sarathi-Serve: PD 分离架构
背景故事
书接上回,在 orca 这篇论文的笔记最后我们发现了 Orca 的 batching 调度的一个局限性; 如果把 prefill 和 decode 阶段的操作 batch 到一起可能会存在比较大的性能差异, 往往 decode 阶段是更快的,而 prefill 阶段会把同批次的 decode 请求拉慢;
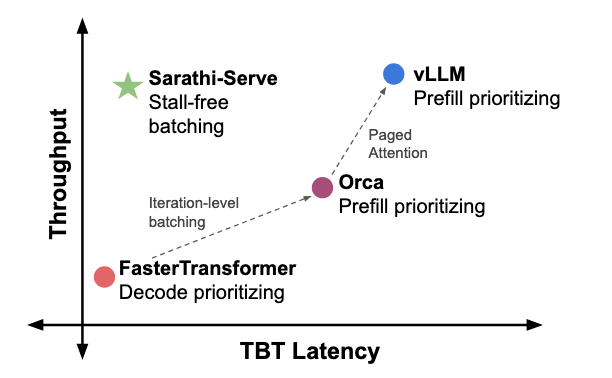
根据分类,使用诸如 Orca/vLLM 的 iteration level batching (也叫 continuous batching), 其实可以理解为优先处理所有请求的 prefill 部分 (只要 GPU 资源有空就拿来处理新请求的 prefill 部分),所以在这篇论文中称之为 prefill-prioritize.
两个核心卡顿
generation-stalls: decode 请求在受到来自 prefill 的 batching 的时候会出现一定时间的 latency 等待pipeline-stalls: 在使用 pipeline-parallel 算法的时候,会将一个完整的 model 按照层 (block) 进行按组分割放到不同的几个 gpu 上进行计算,在理想情况下,每个 gpu 处理的时间相近,那么刚好按照流水线逐个 batch 处理,但是在 pd 分离的架构下,这里的不同 batch 的处理速度会差很大,比如 decode-only batch 和 prefill-included batch 的处理速度完全不在一个量级下,可能会出现 batch/gpu 处理之间的空闲时间,也就是 pipeline-parallel stalls, 或者在 PP 的定义中的bubble
基于两个核心卡顿,论文希望能提出一种算法来中和 prefill 引起的明显时间浪费;
Observed Performance Behavior
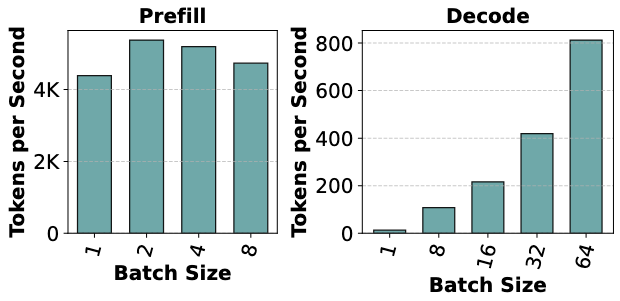
如何理解 prefill 阶段是 compute-bound? 我们要证明这里的 prefill 期间如果增大并发计算量,整体处理速度并不会很明显; 从图中左侧可以看出,这里的 batch size 提升对于 tokens per second (注意在 prefill 阶段这个应该是输入 token 量) 完全不敏感;
而对于 decode 阶段这里是明显和 batch size 呈现类似线性的关系的,也就是 decode 阶段完全依赖于 batching 来提升 GPU 的处理效率和整体速度;
所以结论就是 prefill 可能并不需要 batching, 甚至可以考虑切开,让 compute-bound 不用完整地计算而是弱化,不卡那么多时间
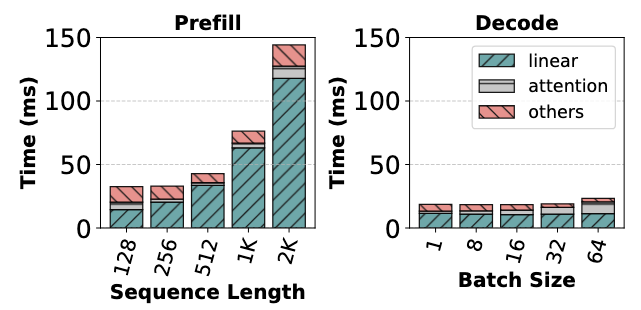
这张图尝试给计算做了一个解构,分成了 linear, attention 和其余计算部分,其中,linear 部分的计算主要包括了 1) X -> QKV 的投影 2) Attention output 的投影 3) FFN 部分的计算; 从图中可以发现, Linear 部分占据了计算的大多数时间消耗
但是由于 KV Cache 的存在 (不是性能) 可以定义整个 decode 阶段的计算维度,所以仍然要考虑 decode 阶段的 attention 部分的张量维度
所以这里的优化应该主要围绕 Linear 部分来进行;
并且我们在 Orca 的 Selective Batching 理念中可以学到 Flatten 操作,也就是把 decode 期间的扁平单 token 地 hidden vector 拼接起来这样提高 gpu 的利用率; 那么这其实也是在提升 Linear 部分的速度; 所以在这张图中可以看出,batch size 从 1 到 64 逐渐增大的时候,linear 部分的总花费时间是不怎么变化的,并且和 prefill 阶段的 128 seq 长度用时是接近的,所以这里突出了 decode 阶段对于 batching 的依赖程度;
Chunked-Prefill
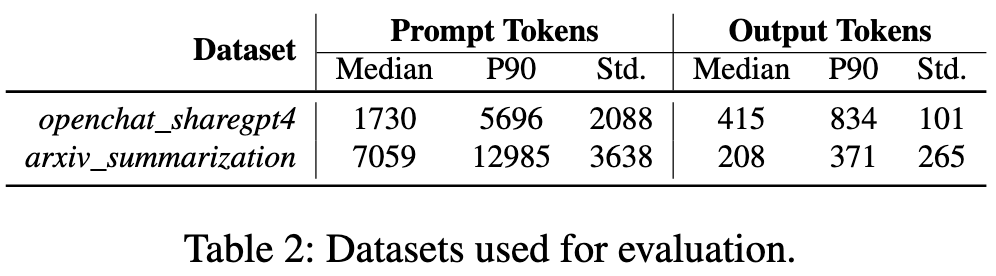
这是 2024 年的 GPT4 的 token 长度中位数,以此可以说明 Prefill 阶段的任务大小